

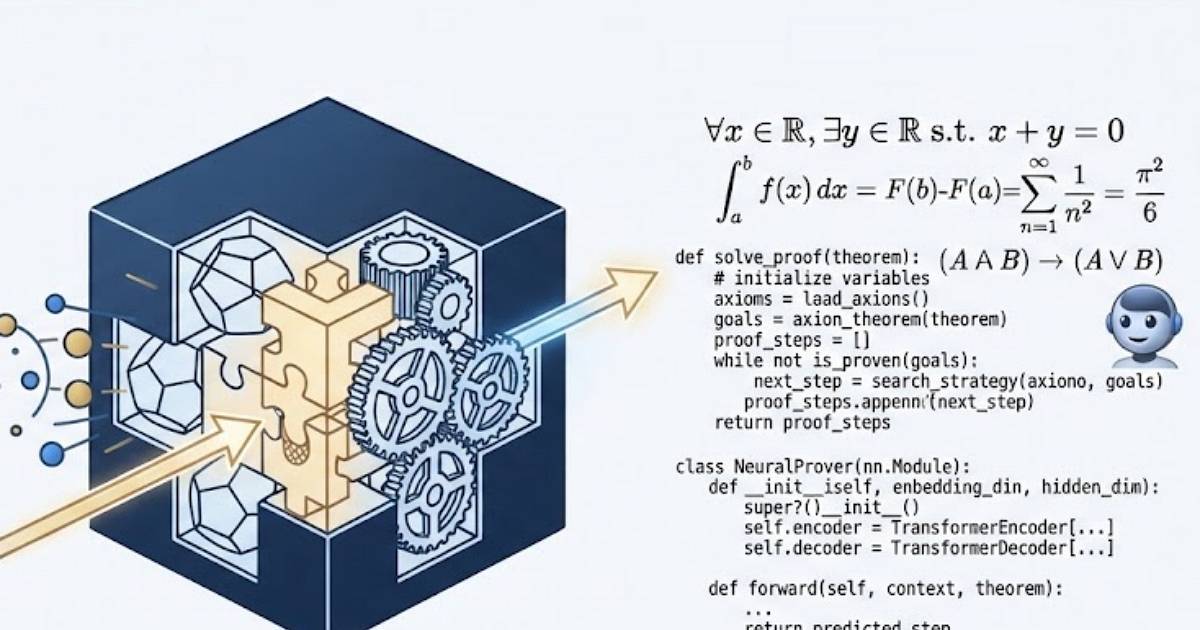
「大型語言模型(LLM)本質上只是在做機率預測,猜測下一個出現的文字(Next-Token Prediction)。」這句話在技術底層百分之百正確。無論是 OpenAI 的 GPT-4o、Anthropic 的 Claude 還是 Google 的 Gemini,它們在訓練時的目標極其純粹——就是看過上文後,猜出下一個字是什麼。
然而令人匪夷所思的是,當模型參數量從數十億飆升至數千億後,這個原本只會「文字接龍」的統計機器,竟然能撰寫複雜演算法、推導國際數學奧賽等級的高階證明。究竟「預測文字」是如何跨越鴻溝,蛻變成「邏輯推理」的?
這項被科學界稱為「智慧湧現(Emergence)」的謎團,如今終於被頂尖研究團隊揭開了其背後的工程真相。
AI 真的在一夜之間「突然開竅」嗎?史丹佛研究揭露評分假象
過去幾年,AI 界普遍流傳著一種神話般的觀點:就像水溫降到攝氏零度會「瞬間結冰」產生相變一樣,大型語言模型在規模跨過某個神秘臨界點時,數學與邏輯能力會發生近乎垂直飆升的「斷崖式暴增」,這種現象被稱為「湧現能力」。
這項假說引發了全球科技巨頭對「暴力堆疊參數量與算力」的狂熱追逐,甚至讓不少人誤以為 AI 已經產生了類似人類靈魂的自我意識躍遷。
然而,榮獲頂級 AI 學術會議 NeurIPS 最佳論文獎的史丹佛大學研究團隊,卻為這場神話澆了一盆冷水。研究人員指出,所謂的「突然開竅」,很大程度上只是「考試評分尺規」造成的視覺錯覺。
舉例來說,在測試「五位數乘法(如 12345 × 67890)」時,傳統測試標準是「全對才給分」;初期較小的模型即便已經掌握了前 9 位數的運算邏輯、僅差最後一位算錯,得分依然是刺眼的「0 分」;當後來的模型稍微進步一點算對全部數字時,分數表上便瞬間跳到「100 分」。若改用評估每一步運算正確率的連續性指標,研究發現 AI 的推理能力其實一直都在「鴨子划水」般平穩線性增長,並非神蹟般的突變。
為什麼「文字接龍」會逼出「數學邏輯」?
既然不是魔法,那麼 AI 究竟是如何從文字接龍學會嚴密推導的?答案藏在資訊理論的「極限資料壓縮」之中。
如果只是要背誦幾千首唐詩或莎士比亞全集,AI 靠死記硬背的記憶力就能輕鬆猜對下一個字;然而,當訓練資料擴大到全人類數十億網頁、各國法律條文、海量 GitHub 程式碼與無數篇尖端數學論文時,任何神經網路的記憶體都絕對不可能把所有句子的排列組合全部背下來。
為了以最高的統計勝率「精準猜中下一個字」,AI 的神經網路在龐大的反向傳播演算法壓力下,被迫在內部「自行發明了一套終極壓縮機制」——那就是提取出人類語言背後最底層的「文法結構、因果關係與數學邏輯運算迴路」。
換言之,邏輯不是工程師寫死在程式裡的,而是模型為了以最精簡的參數量記住龐大世界規則,所演化出的最高效率工具;神經網路內部逐步成形了無數個類似樂高積木的微型運算模組,當面對從未見過的全新數學問題時,模型便能自發調用這些邏輯積木,拼湊出嚴密且正確的推導步驟。
從被動接龍到自主反思:DeepSeek 與長思考鏈開啟推理新紀元
這項理解在近期登場的推理大模型(如 DeepSeek-R1 與 OpenAI o 系列)中得到了最極致的體現。不同於傳統模型直接給出最終答案,新一代模型透過強化學習(Reinforcement Learning),在神經網路內部自發演化出了長達數萬字元的「長思考鏈(Chain of Thought)」。模型在解題過程中學會了像頂尖數學家一樣自主草擬步驟、在遇到矛盾時停下來說「等等,我前面好像算錯了(Wait...)」並進行自我修正,將邏輯推導的精準度推向全新巔峰。
從「猜測下一個詞」到「解答人類未解的科學難題」,大型語言模型的演進證明了:極致的統計預測,必然會孕育出理性的邏輯結構。AI 雖然沒有人類的情感與知覺,但透過在極限算力中刻寫出的數學神經迴路,它已經成為人類探索科學邊界時,最強大且不可或缺的智慧協同夥伴。


請注意!留言要自負法律責任,相關案例層出不窮,請慎重發文!