

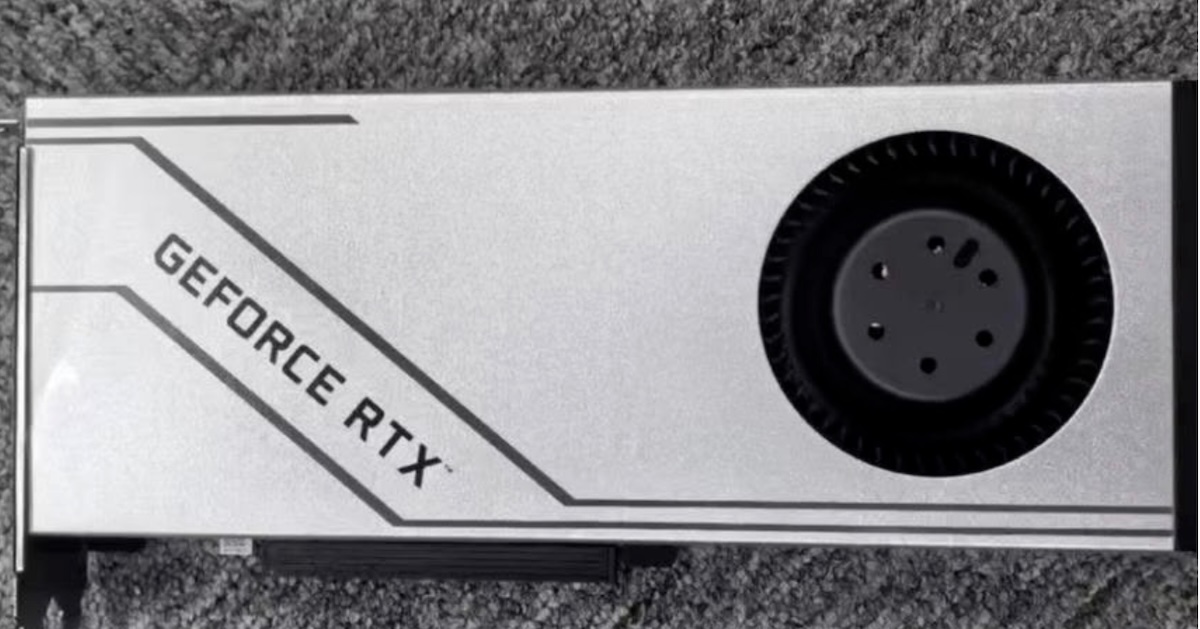
近日中國阿里巴巴電商平台上,赫然出現一款由深圳速橋科技打造的「魔改版」GeForce RTX 5090 顯示卡,最大亮點並非核心運算時脈,而是將原廠 32GB 顯示記憶體一口氣擴充 3 倍來到驚人的 96GB,且開價僅 3,888 美元(約合新台幣 12.6 萬元)。相較於動輒 1.6 萬美元起跳的專業工作站卡,這項產品瞬間在 AI 開發圈引爆話題。
為何 AI 開發者寧可買魔改卡?

對於純粹追求高畫質 3A 大作的頂級電競玩家而言,標準版 RTX 5090 配備的 32GB GDDR7 記憶體早已綽綽有餘,甚至在絕大多數遊戲場景中都處於效能過剩狀態。
然而,對於需要於本地端部署大型語言模型(LLM)、進行模型微調或跑複雜深度學習訓練的 AI 開發者來說,記憶體容量往往是比純粹算力更加殘酷的硬門檻。一旦大模型的參數量突破 700 億(70B)甚至更高規模,單張 32GB 顯示卡即便經過高強度量化也難以完整載入,往往必須被迫串聯多卡或花費巨資租用雲端伺服器算力。
正因如此,輝達(NVIDIA)面向專業工作站與企業市場的 RTX PRO 6000 Blackwell 雖然同樣擁有 96GB 記憶體,但官方報價高達 1.6 萬至 1.8 萬美元(折合新台幣 50 萬至 58 萬元不等)。這款魔改版 RTX 5090 僅開出 3,888 美元的破盤價,即使對比目前美國市場上被炒作至 6,000 美元的消費版原卡都顯得極具性價比,自然直接打中了個人研究者與新創團隊的敏感神經。
拋開商業動機,從純硬體架構的角度剖析,這項看似瘋狂的改造在理論上確實具備一定可行性。消費級 RTX 5090 與專業級 RTX PRO 6000 Blackwell 共享了相同的 GB202 核心晶片,這意味著該 GPU 原生架構在記憶體控制器與定址能力上,本就具備支援 96GB 容量的底層潛力。
不過,原廠消費級 RTX 5090 的印刷電路板(PCB)並未預留足夠的記憶體焊位。製造商若要實現 96GB,勢必得重新自主洗板設計特規 PCB,並採用正反雙面的「三明治(夾層式)」布局,在有限板幅內塞進 32 顆單顆容量為 24Gb(3GB)的 GDDR7 記憶體顆粒。
除了重新布線設計 PCB 外,晶片來源也是一大技術刀法。
廠商通常有兩種手段:直接向供應鏈管道採購未封裝的 GB202 晶片,或是將現有市售 RTX 5090 的 GPU 核心拆卸下來進行重新植球(BGA Reballing),再焊接至全新的客製化基板上。更關鍵的關卡在於韌體(vBIOS),硬體顆粒焊接完畢後,GPU 必須能夠正確識別拓撲結構與定址分配。過去在 RTX 3090 48GB 與 RTX 4090 48GB 的魔改案例中,工程人員便曾透過破解修改後的工程韌體成功點亮,而業界早有傳聞指出支援 RTX 5090 的外洩韌體已在黑市流傳數月,這也為 96GB 改造鋪平了理論道路。
此外,從實體曝光的照片來看,該卡採用了標準雙槽(2-Slot)厚度與後置離心渦輪扇(Blower)設計。這種設計完全捨棄了消費級常見的三槽巨型風扇,顯然是為了能緊密堆疊於 4U 伺服器或工作站機箱內,鎖定的正是高密度運算市場。
規格破綻百出?看魔改神卡的潛在風險
儘管架構理論看似美好,但阿里巴巴商品頁面所揭露的關鍵規格,卻充斥著令人難以自圓其說的嚴重矛盾。
頁面上的規格欄位竟標註該卡使用的是「GDDR6X 記憶體」,且時脈速度僅有「14Gbps」。從半導體物理常識來看,目前美光(Micron)量產的 GDDR6X 顆粒最高單顆容量僅有 16Gb(2GB),即便在 PCB 正反兩面焊滿 32 顆,極限容量也只能達到 48GB,在數學上根本不可能拼湊出 96GB 的規模。
再者,GDDR6X 的標準傳輸速率落在 19Gbps 至 24Gbps 之間,14Gbps 反而是上一代 GDDR6 的標準,而 Blackwell GB202 原生搭載的更是新一代高速 GDDR7,這組規格組合在技術邏輯上完全牛頭不對馬嘴。
這種破綻百出的規格標註,究竟是賣家在刊登商品時對技術參數不求甚解的「粗心誤植」,還是商家企圖藉由誇大容量來吸引買家付訂金的「空頭支票」?對於急於尋求廉價 AI 算力的使用者而言,在看清真相前,還是先別急著將這張 3,888 美元的卡王放進購物車。
- 延伸閱讀:被外媒酸為「這一代最沒意義的顯卡」,NVIDIA RTX 5080 性價比慘烈失衡
- 延伸閱讀:NVIDIA DLSS 5神經渲染效能實測:畫質有感提升但FPS效能砍半
- 延伸閱讀:Win10延壽也沒用?NVIDIA宣布2026年10月終止驅動支援,PC玩家換機倒數開始


請注意!留言要自負法律責任,相關案例層出不窮,請慎重發文!