

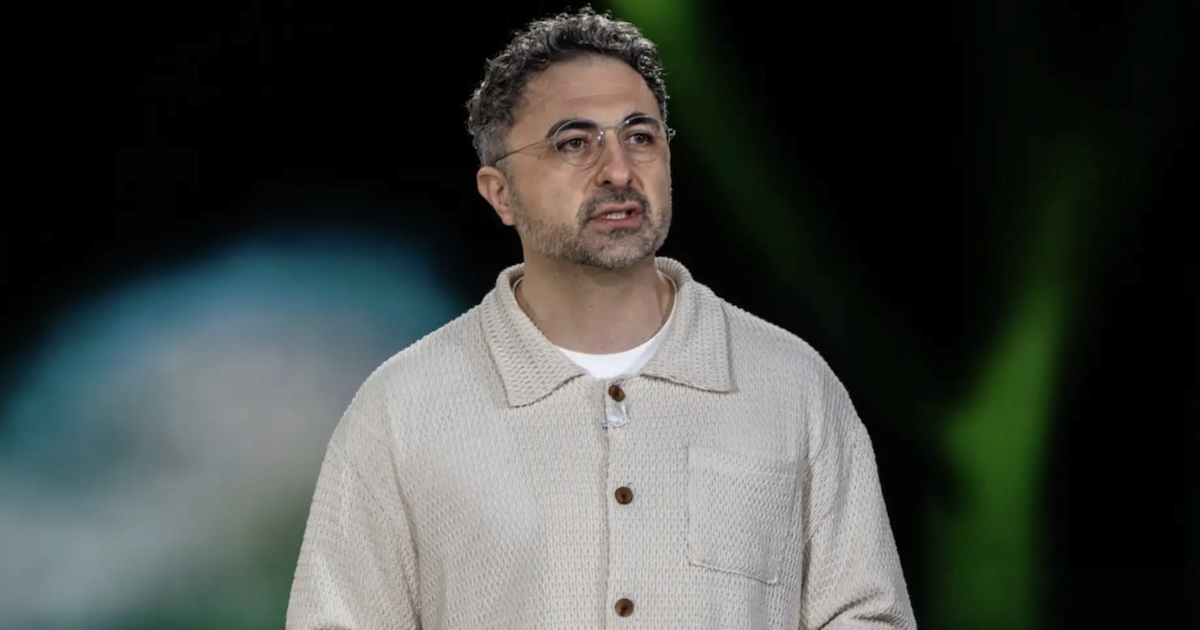
據《商業內幕》報導,微軟AI事業CEO穆斯塔法·蘇萊曼(Mustafa Suleyman)告訴員工,微軟自研的一款模型比OpenAI提供的類似模型還要好。而OpenAI目前是微軟最大客戶與合作夥伴之一。
蘇萊曼在週四的員工大會上表示:「我們現在擁有一個更強大的預訓練基礎模型,性能超過目前驅動GPT 5.6 Sol的模型。事實上,我們訓練這款模型所用的算力,只有OpenAI訓練其模型所用算力的四分之一。」
預訓練是打造AI模型的第一階段——模型在這個階段從海量文字、圖像與其他資訊中學習規律。這個過程要燒掉大量昂貴算力,如果微軟真的找到更高效的訓練方法,就能省下可觀成本。
微軟在週四稍早宣布了這款模型,名為MAI-Base-2,並表示公司最近完成了這款模型的預訓練。它採用混合專家(MoE)架構,總參數量達2.8兆,啟動參數量為800億。
蘇萊曼表示,微軟私下把這款模型跟OpenAI的模型做了對測,其中包括一款代號「Spud」、驅動GPT-5.6的模型。他補充說,在衡量AI理解與預測資訊模式能力的測試中,微軟的模型表現更好。「我們也在私下、保密的情況下,把它跟OpenAI的模型做了比較。」蘇萊曼對員工說,同時暗示微軟能取得關於OpenAI模型表現的特殊資訊。
即使是在私下場合,蘇萊曼也在強調OpenAI模型的局限。微軟已經對OpenAI投資數十億美元,並持有這家新創公司的股份,價值可能超過1000億美元——任何對OpenAI的批評,都可能影響這筆巨額投資的價值。兩家公司還建立了重要的合作關係:微軟透過Azure雲端服務向客戶提供OpenAI模型,也在Copilot等自家產品中使用OpenAI的模型。
但過去一年左右,兩家公司的關係逐漸出現裂痕。微軟愈來愈嘗試擺脫對OpenAI的依賴,包括著手研發自己的模型。
蘇萊曼還表示,從算力使用效率來看,微軟這款新AI模型所需的計算量只有DeepSeek的十二分之一。他沒有具體說明是哪一款DeepSeek模型,但微軟在一篇公開部落格文章中稱,MAI-Base-2的預訓練效率高於DeepSeek一款類似產品,名為DeepSeek-V4-Pro-Base。
今年3月,微軟為面向企業與消費者的Copilot產品組建了新的聯合團隊,並把蘇萊曼調任到公司的超級智能部門,專注打造AI模型。
- 延伸閱讀:ChatGPT生成圖竟直接冒用畫家簽名,OpenAI被控「身分竊盜」惹怒《紐約客》名家
- 延伸閱讀:OpenAI GPT-6.1 Sol 記憶力有感升級!預設上下文長度暴增80% ,解決 AI 忘東忘西痛點
- 延伸閱讀:OpenAI發表Intelligent UI:互動式地圖、食譜一按就通,這類用戶搶先玩


請注意!留言要自負法律責任,相關案例層出不窮,請慎重發文!