

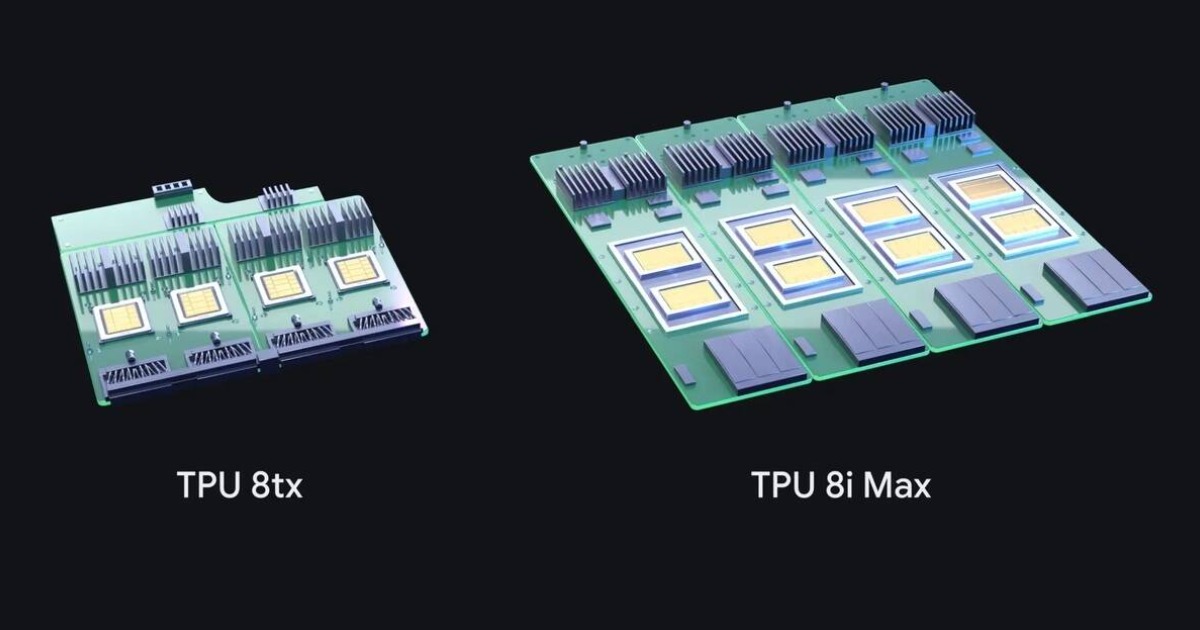
Google 正式發表兩款基於第八代架構打造的專用 AI 加速晶片「TPU 8tx」與「TPU 8i Max」。兩款新處理器分別鎖定受高度法規監管的高資安機密運算場景,以及需要處理海量資訊的超長上下文大模型推理需求,透過特定硬體規格的客製化調整,全面滿足企業級人工智慧應用在落地時的差異化痛點。
這項硬體擴充展現出 Google 在資料中心與雲端運算戰略上的重要轉向:不再盲目追求單一全能晶片的算力極限,而是精準針對企業客戶的具體工作負載打造專業衍生型號。隨著新晶片加入,Google 旗下第八代 TPU 家族已構築起涵蓋訓練、低延遲、高資安與超長上下文的完整產品矩陣,強勢迎戰英偉達在 AI 基礎設施市場的統治地位。
機密運算整合硬體防護,聯手處理器捍衛資料安全
TPU 8tx 專門針對金融服務、醫療健康、政府機構及高度合規性產業量身打造,將機密運算能力直接深植於硬體架構中。這款晶片與 AMD 處理器深度協同工作,透過底層矽智財整合先進加密技術,確保人工智慧模型在載入、運算與推論的全生命週期中,其神經網路模型權重與企業敏感輸入資料始終處於高強度加密狀態。
傳統雲端解決方案在進行神經網路計算時,通常必須將資料先解密並載入至記憶體中,這使得敏感資訊容易暴露於記憶體側信道攻擊或未授權的系統層級存取威脅。TPU 8tx 透過與 AMD 安全處理器的硬體級聯動,徹底消除了記憶體資料裸露的安全死角,為極度看重商業機密與隱私合規的跨國企業,鋪平了在公有雲環境部署先進生成式 AI 的安全坦途。
擴充記憶體與運算資源,助攻AI代理與超長文本推理
另一款新品 TPU 8i Max 則專門針對需要吞吐海量資料的超長上下文窗口(Long Context Window)大模型應用而設計。近年來,隨著生成式 AI 與具備多步驟自主決策能力的 AI 代理(AI Agents)技術快速崛起,越來越多前端模型需要一次性讀取數百萬字的研究報告、整座微服務專案的原始代碼庫或歷史財務數據,這對硬體的記憶體容量、頻寬與推論效率提出了極端嚴苛的要求。
據 Google 官方說明,TPU 8i Max 透過顯著增強計算單元密度與高頻寬記憶體資源配置,能夠無縫支援超長上下文視窗,讓 AI 模型在單次請求中分析巨量脈絡而不發生效能衰退或精度遺失。這項能力對於需要深層語意理解的複雜程式碼自動重構、高難度數學推理、新藥靶點研發以及跨學科科學文獻交叉分析等頂尖研究場景尤為關鍵,能協助模型保留完整歷史背景並大幅提升產出品質。
Google AI 基礎設施負責人阿明·瓦赫達特(Amin Vahdat)表示,這兩款晶片並非推倒重來的全新架構,而是立足於成熟的第八代 TPU 技術基礎上,針對客戶實際業務需求所進行的專項最佳化衍生型號。Google 深刻體認到,與其打造一款試圖包山包海卻成本高昂的通用型晶片,不如針對特定利基場景雕琢出極致特化的專業硬體,更能為雲端企業客戶創造更高的投資報酬率。
今年早些時候,Google 已率先推出第八代 TPU 系列中的主力成員 TPU 8t 與 TPU 8i,前者專門負責超大規模神經網路的模型訓練任務,後者則特別針對日常應用的極致低延遲推論進行了最佳化。隨著 TPU 8tx 與 TPU 8i Max 的強勢加入,Google 第八代 TPU 家族已擴展為完整的四款產品線,全面覆蓋超大規模模型預訓練、硬體級安全機密推理、極致響應速度推論以及超長上下文巨量資料分析。
分析人士指出,Google 最初研發 TPU 主要為了支持內部各項旗艦產品的 AI 運算,如今已演化為 Google Cloud 雲端運算業務爭奪外包合約的最強武器。在當前全球算力市場中,TPU 已經成為英偉達 GPU 生態系之外最不可忽視的 AI 計算平台,受到眾多新創巨頭與跨國企業青睞;新型號的到位將進一步增強 Google 在 AI 底層基礎設施賽道中的話語權。
- 資料來源:cnBeta


請注意!留言要自負法律責任,相關案例層出不窮,請慎重發文!