

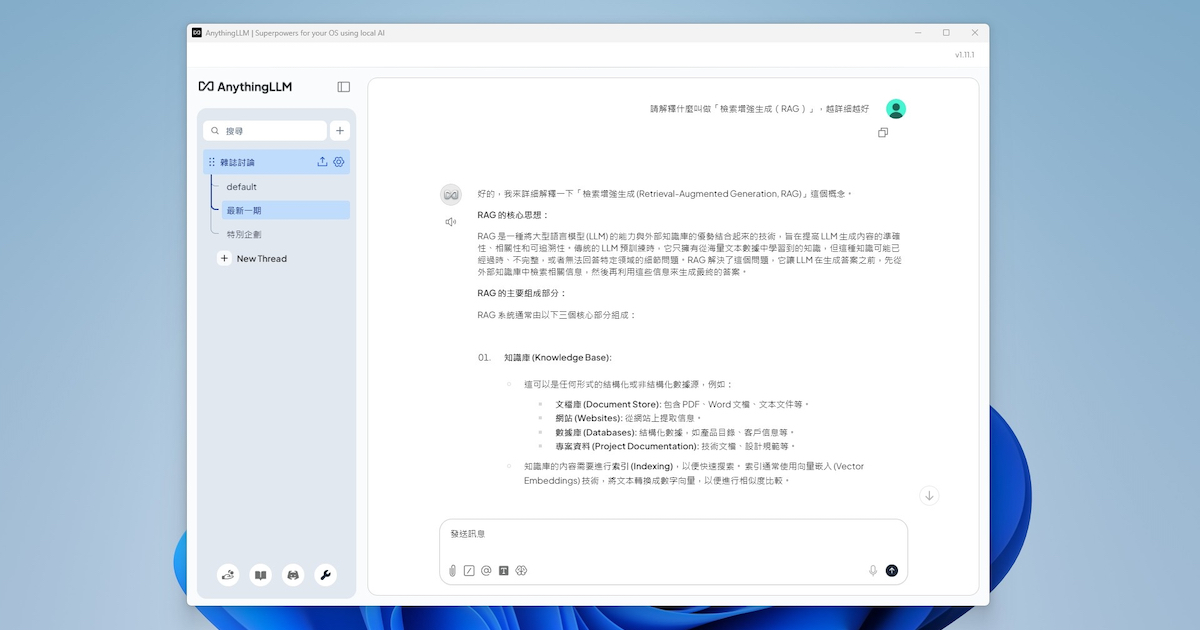
隨著 AI 深入工作、生活應用情境的機會不斷增加,相信很多人都曾經想過,讓自己手上的人工智慧變得更加個人化。
- 延伸閱讀:什麼是RAG?RAG技術突破LLM限制,結合「資訊檢索」和「文字生成」動態獲取知識大幅提升
- 延伸閱讀:Intel Vision 24:Intel與合作夥伴共建AI開放平台,搭配RAG技術強化企業私有LLM應用
- 延伸閱讀:為什麼 LLM 無法建構大型專案軟體?Zed 工程師點出關鍵差異
然而,大多數網頁端平台的 AI 應用,比如 OpenAI ChatGPT 與 Google Gemini 等服務,經常都只能回答較為廣泛的知識,缺乏對特定領域的深入理解,並給予使用者不夠準確甚至錯誤的答案。
在這種情況下,若使用者願意嘗試透過不一樣且更加客製化的工具,例如本次介紹的 AnythingLLM,藉由手動匯入資料與參考文件的方式,建立屬於自己的 AI 知識庫,讓通用人工智慧變得更加聰明,或許會是非常值得一試,低成本、高效率的解決方案。
減少 AI 幻覺的 RAG 技術
眾所周知,當今的 AI 基本上都是由俗稱 LLM 的「大型語言模型」所驅動,無論是 OpenAI ChatGPT 或 Google Gemini,這些 AI 前端應用和聊天機器人的背後,全都仰賴著特定 LLM 的運算能力。
然而,即便人工智慧技術已經出現了大幅進步,但 LLM 仍然面臨著嚴重的「幻覺」問題,也就是 AI 所給予使用者的答案,不一定每次都完全正確。
更關鍵的一點在於「幻覺」是目前大多數 AI 模型架構中,必然會發生的事情,所以如何減少幻覺的產生,就成為科學家與 AI 開發商想要積極解決的問題。
為了降低 AI 幻覺造成的影響,一種被稱為「檢索增強生成(RAG)」的技術浮上了檯面,藉由將 LLM 本身的生成能力,以及即時資訊檢索的動作互相結合,藉此提高最終輸出結果的精確度,進而避免 AI 幻覺的產生。
RAG 與知識庫的建立
簡而言之,RAG 技術就是提供給 LLM 一個附加的資料庫,要求 AI 在生成答案之前,不只要運用自己曾被訓練過的資料給出結論,還要再依序執行「檢索」、「增強」與「生成」三個步驟,藉此提升輸出回應的可信度。
所謂「檢索」就是指使用者向 AI 提問之後,命令 LLM 事先搜尋資料庫中的參考文檔,接著再把檢索到的資料,跟原始問題共同組合成「增強」版的提示詞,最終讓 LLM 根據整合的數據「生成」精確回答。
RAG 技術的優勢,在於能夠讓 LLM 取得更新、更準確,而且由使用者個人所定義的知識以回應各種提問,同時又不會喪失 LLM 本身的智慧能力。
聰明的讀者應該已經能夠理解,為什麼 RAG 可以被當成建立個人知識庫的絕佳技術應用,畢竟被 LLM 檢索的資料庫中,想要放進哪些數據,例如參考文件、操作指南或即時資料等,全都可以由使用者自行決定,所以才成為打造客製化 AI 應用最簡單、方便且有效的解決方案。

為什麼選擇 AnythingLLM?
如果只是單純上傳文檔資料,並要求 AI 參考文件給予更加精確的解答,那麼無論是網頁端的 ChatGPT 或 Gemini,其實都可以辦得到,為什麼還要刻意透過 AnythingLLM,建立另外一個使用環境呢?
原因在於,AnythingLLM 不僅具備資料管理的方便性,還能夠提升使用者的隱私保障,甚至是壓低 AI 聊天機器人的使用成本。
首先,AnythingLLM 擁有一套相當直觀、直覺的操作介面,可以讓使用者在最短時間內,上手如何把參考文件「向量化」,接著輸入到資料庫之中,供應 LLM 進行 RAG 檢索使用。
其次,當使用者擁有大量文件必須匯入資料庫時,AnythingLLM 在管理操作上的方便性,比起網頁雲端平台也來得更加優秀。
再者,既然要建立個人化的檢索資料庫,那麼其所包含的文件內容,勢必會比公開資料更為敏感,即使每一個雲端平台都十分強調安全保障,但只要資料上傳到網路環境,那麼就隨時擁有外洩的可能,而在本機執行 AI 與資料管理的 AnythingLLM,相對之下就安全許多。
最後,由於 RAG 技術會讓提示詞變得更精確,並要求 AI 理解更多資料,因此多少會增加 LLM 的算力消耗。
在大多數雲端平台上,當 AI 所需要的算力增加,就代表使用者的支出會跟著提升,此時支援本機 LLM 運算,又允許連接雲端 API 的 AnythingLLM,就是個兼具使用彈性,還能進一步壓低開銷的絕佳選擇。
安裝 AnythingLLM,以內建 LLM 引擎啟用 AI 模型
跟市面上其他本機 AI 模型啟動器相較,AnythingLLM 既沒有 Ollama 如此簡單純粹,也不像 LM Studio 一樣擁有複雜的設定介面。
基本上,使用者只需準備好一台效能足夠的電腦,並從網站下載 AnythingLLM Desktop 應用程式,軟體就會自動安裝必備的各種套件和工具,可以稱得上是「All-in-One」與「開箱即用」。
只不過要特別注意之處,在於 AnythingLLM 的執行環境部署,還可以透過官方所釋出的 Docker 版本。該版本雖然功能更加多元,可是建構過程相對麻煩許多,比較適合中小企業或具有一定規模的組織使用。
AnythingLLM Desktop 網址:https://anythingllm.com/
步驟 1:首先來到 AnythingLLM 官方網站,然後點選中央的「Download for desktop」按鈕。
步驟 2:接著選擇對應自身電腦作業系統的安裝程式,此處以 Windows 的 x64 版本進行示範。
步驟 3:持續點擊「下一步」進行程式安裝,若使用 NVIDIA 顯示卡,過程中遇到「Ollama CUDA」的下載作業時會比較耗費時間。
步驟 4:程式安裝完成後,AnythingLLM 的主程式應該會自動開啟,點擊中央的「開始使用」。
步驟 5:首先選擇 LLM 偏好。若是在不仰賴雲端平台的情況下,請點擊「AnythingLLM」,由內建的 Ollama 作為 AI 模型的執行引擎。
步驟 6:接著將畫面往下捲動,可以看到 AnythingLLM 推薦安裝的數個 AI 模型,此處可以先選擇最輕巧的 Google Gemma3 1B 驗證使用環境。
步驟 7:選擇要使用的 AI 模型後,畫面右上角及下方,皆有提示告知模型的下載進度;參數越大、能力越強的模型,需要效能越強的電腦才可以運作。
步驟 8:在「資料處理與隱私」頁面,AnythingLLM 會預設啟用內建的「嵌入模型」與「向量資料庫」供 RAG 使用,因此通常都不需要變更。
步驟 9:初次設定步驟的最後,AnythingLLM 會詢問使用者的電子郵件,若不願意提供,可以按最下方的「跳過調查」。
步驟 10:接著程式就會自動跳轉到 AnythingLLM 的主畫面,後續我們將以此為起點,進行 RAG 參考資料匯入與 AI 聊天等各種作業。
步驟 11:若使用者安裝完成卻發現介面為英文,請按左下角的「扳手」圖示,並於「介面自訂」的「使用者偏好設定」中更改顯示語言。
設定工作區與對話串,將參考文件匯入 RAG 資料庫
在操作方面,跟雲端平台把所有與 AI 進行的對話、聊天,通通混在單一網頁介面中不同,AnythingLLM 主打以「工作區」為核心,方便使用者輕鬆分類自己跟不同 AI、不同作業任務、不同資料庫之間的對話、互動與參考文件。
簡單來說,一個工作區就是一個獨立的作業空間,當使用者把參考文件匯入到指定工作區的 RAG 資料庫時,AI 就只會去讀取特定的資料,不會跟其他工作區的數據互相干擾,進而影響 AI 的記憶、輸出和資料調用。
步驟 1:開啟 AnythingLLM 主畫面後,點一下搜尋欄位旁邊的「+」號,新增一個新的工作區。
步驟 2:接著為工作區進行命名, 然後點擊右下角的「Save」。
步驟 3:畫面左邊條形框較大的分類為「工作區」,條形框較小且位於其下的是「對話串」;工作區可以自由拖拉排序,對話串則可以修改命名。
步驟 4:再來開始為工作區的 RAG 資料庫匯入參考文件。先點擊工作區名稱旁邊的「上傳」圖示。
步驟 5:接著在跳出來的畫面中,選擇下方的「點擊上傳或拖放檔案」。
步驟 6:將電腦中的參考文件,舉凡文字檔、試算表、音訊等檔案,全部選擇後,按下「開啟」。
步驟 7:接著畫面上方會顯示檔案清單,而下方帶有綠色勾勾的項目,為已經獲得 AnythingLLM 支援且接受的參考文件。
步驟 8:再來從上方的文件清單中,點擊左邊方框圖示選擇資料,挑選要被向量化並匯入 RAG 資料庫的檔案,然後點一下「移動到工作區」。
步驟 9:當被挑選的文件從左邊跑到右邊,即可按下「儲存並嵌入」將其轉化為向量,匯入 RAG 所使用的資料庫中,供 AI 模型檢索、讀取。
步驟 10:當右邊清單中的文件出現「返回」圖示,表示該檔案已經被嵌入在向量資料庫當中。點擊右上角的「X」即可回到主畫面。
步驟 11:接著使用者就可以透過自然語言,經由聊天的方式對 AI 進行提問,而 AI 模型也會利用 RAG 技術,主動檢索向量資料庫中的參考文件。
設定系統提示詞,切換精確查詢模式
雖然說在 RAG 技術的輔助之下,AI 模型應該會利用參考文件給出更加精確的答案。然而,驅動 AI 聊天機器人的幕後推手,依然是具備隨機性的 LLM,因此 AI 幻覺問題依然無法得到革除。在這種情況下,假若使用者發現 AI 偶爾還是會忽略指令,從自身訓練數據中輸出非常離譜的答案,同時認為 AI 給予的回答不夠精確,就可以考慮啟用 AnythingLLM 內建的「查詢模式」。
此外,由於 AnythingLLM 主要在本機端運作,因此使用者能夠於程式中,為 AI 設定全域或個別的「系統提示詞(System Prompt)」,進一步解釋 AI 模型扮演的角色、對話背景和基礎規則。
步驟 1:開啟 AnythingLLM 的主畫面後,於左邊找到「扳手」圖示,點一下進入設定。
步驟 2:接著於左邊找到「系統管理」下面的「Default System Prompt」,右邊就是「全域」系統提示詞的輸入與修改位置,官方已經預設了一組。
步驟 3:除了影響所有工作區的全域系統提示詞,個別工作區也可以單獨進行設定。首先按一下工作區名稱旁邊的「齒輪」圖示。
步驟 4:接著在上方的分頁中,切換到「對話設定」畫面,往下找到「提示詞」即可修改;此處設定會取代全域提示詞,為該工作區所獨有。
步驟 5:至於「對話模式」的修改同樣在此畫面,點一下就能將預設的「對話」改為「查詢」,再按右上角的「Update Workspace」即可完成。
連動瀏覽器擴充功能,快速導入知識文件
除了匯入使用者本來就已經擁有的參考文件外,官方還開發了 Google Chrome 瀏覽器專用的擴充功能,方便使用者快速將網頁內容,直接轉存到工作區的 RAG 資料庫,供 AI 模型後續進行檢索與參考。
使用 AnythingLLM 瀏覽器擴充功能的一大好處,在於使用者不必再額外執行複製、貼上的動作,也不必手動將整個網頁下載到電腦中,亦可指定想要的文字或文章段落進行轉存,藉此避免參考資料過多以降低 AI 的查詢效率。
只不過,目前該瀏覽器擴充功能僅限於 Google Chrome 使用,而且部署過程中需要進行一次 API 金鑰的連結。
AnythingLLM Browser Companion 網站:https://tinyurl.com/y73zmkes
步驟 1:首先點擊左下角的「扳手」圖示,接著找到「工具」下方的「瀏覽器擴充功能」,然後點選「Generate New API Key」。
步驟 2:接著在跳出來的畫面中,點擊右下角的「Create API Key」。
步驟 3:點選「Copy API Key」將金鑰複製備用。然後打開 Chrome 瀏覽器,安裝 AnythingLLM 的擴充功能。
步驟 4:擴充套件安裝完畢後,將前一個步驟所複製的 API Key,貼上到輸入框中,再按下「Connect」。
步驟 5:當擴充功能狀態顯示為「Connected」,即可隨時於網頁上按滑鼠右鍵,找到選項把整篇網頁或特定文字匯入工作區,記得要再進行嵌入操作。
啟用內建會議助理,轉錄與總結錄音檔
為了使 AnythingLLM 更加具備生產力,官方特別在軟體之中,內建了一套被稱為「Meeting Assistant」的「會議助理」功能。
雖然字面上有些難以理解,但其實會議助理功能,就是透過 AI 技術同步轉錄開會過程中的音訊為文字,接著再交由 LLM 進行統整、結論。
根據筆者實測,AnythingLLM的會議助理功能出乎意料之外的強大,因為其預設的語音轉文字模型Parakeet,以英文辨識來說不僅品質相當高,甚至還可以識別出不同的說話者,唯獨暫不支援中文且無法手動更改,稍嫌可惜。
步驟 1:要使用會議助理功能,首先點選左下角的「扳手」圖示,接著找到「Meeting Assistant」或「會議助理」。
步驟 2:按下步驟一畫面的「Start recording」或上傳音訊檔案後,AI 模型就會開始自動處理音檔,並於「Transcript」欄位顯示轉錄後的文字與說話者。
步驟 3:切換到「Summary」頁面,會議助理將採用 AnythingLLM 預設的 AI 模型,為從音訊轉錄出來的文字內容進行列點、總結。
步驟 4:當點擊步驟三畫面的「Ask Qusetions」後,程式將跳回主畫面,允許使用者透過自然語言,向 AI 針對剛才轉錄的會議內容進行提問。
步驟 5:在步驟一畫面點擊右上角的「設定」圖示與「Preferences」選項,可確認轉錄模型是否已經正確下載,同時也可設定是否要辨識說話者。
調用 AI 代理技能,獲取網路搜尋能力
即使 RAG 已經能夠減少 LLM 的幻覺產生,並且使 AI 獲得相對較新的資訊,但如果可以讓 AnythingLLM 直接擁有搜尋網路即時資料的能力,那麼使用體驗自然就能更上一層樓。
為此,我們必須使用 AnythingLLM 內建的「智慧代理人技能(Agent Skills)」功能,使 AI 可以經由存取第三方服務 API 的方式,從 Google 搜尋取得即時資訊。
在本次教學中,筆者選擇免費註冊帳號即贈送 2500 次網路搜尋額度的 Serper,並於取得 API 金鑰後,匯入 AnythingLLM 進行綁定,接著再使用內建指令,要求 AI 代理調用自身技能以存取搜尋功能。
Serper網站:https://serper.dev/
步驟 1:首先來到 Serper 官方網站,點選右上角的「Sign up」依指示註冊帳號,免費取得 2500 次搜尋額度。
步驟 2:登入 Serper 平台後,於左邊找到「API Keys」,再點右邊「Create New Key」,輸入金鑰名稱並按「Create」,然後點雙方框圖示複製金鑰。
步驟 3:開啟 AnythingLLM 後,點選左下角「扳手」圖示並找到「智慧代理人技能」,再選擇「Web Search」將右邊的開關啟用。
步驟 4:在右邊下方的選單中找到「Serper.dev」服務,並於「API Key」輸入框貼上步驟 2 複製的金鑰,最後點擊「Save」。
步驟 5:隨意開啟任意工作區與對話串,並於提問時在最前方加上「@agent」指令,再透過自然語言要求 AI 調用網路搜尋功能,即可得到最新資訊。
本文同步刊載於 PC home 雜誌
歡迎加入 PC home 雜誌粉絲團!


請注意!留言要自負法律責任,相關案例層出不窮,請慎重發文!