

替 AI 代理人(AI Agent)擴充自訂技能(Skills),真的能讓開發效率翻倍嗎?答案可能讓你有點意外。
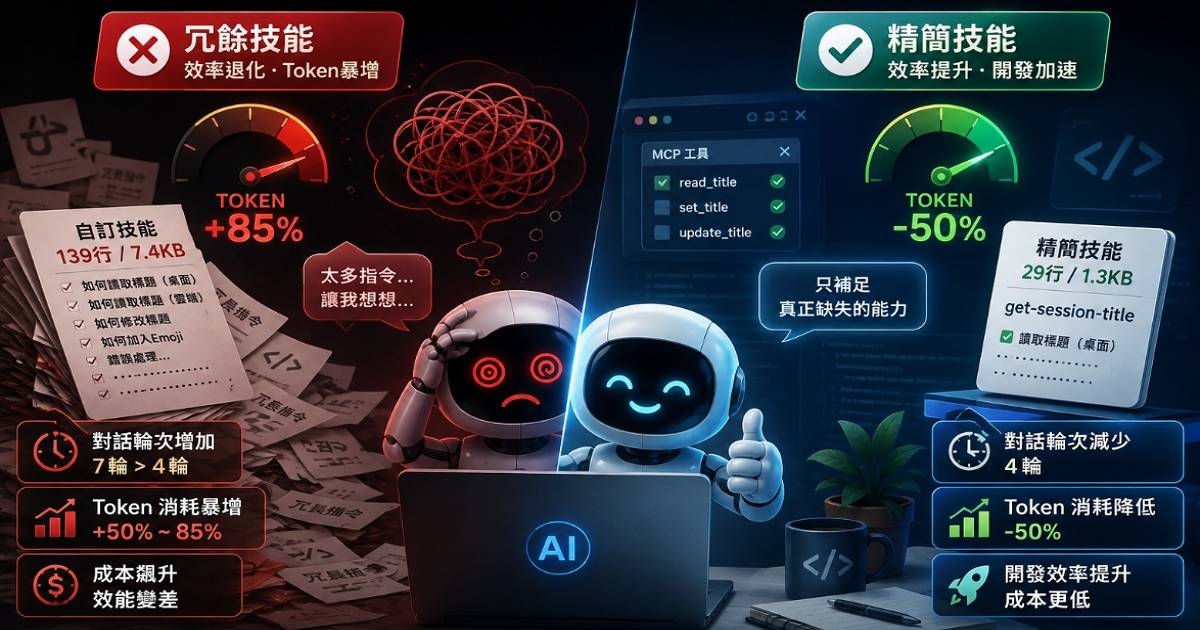
日本資深軟體工程師 かわしん(kawasin73)近日發表了一篇文章,他表示,自己最近在一次的實測中,意外發現自己為 Claude Code 撰寫的自訂技能,不但沒有加速工作流程,反而因為注入冗餘指令,導致對話輪次增加、Token 消耗量暴增近一倍,實質引發了「AI 效能退化」。
「自從習慣用 AI 寫程式後,我自己連 Code Review 都很少做了,甚至連 AI 生成的技能程式碼我也懶得看,只要程式能跑就覺得『萬事大吉』。」
作者在技術專欄中坦言,當在沒有嚴謹評估的情況下盲目堆疊自訂技能時,AI 往往會在「看似順利完成任務」的假象下,卻於暗處默默吞噬龐大的 Token 成本與運算時間。
在一次專案中發現的問題
在日常開發流程中,他表示習慣使用 Claude Desktop 應用程式並行開啟多個工作階段(Session)進行多工開發,並在每次工作階段結束時執行回顧技能以持續改善開發環境。對於很多進行AI開發的朋友來說,他的這些動作應該大家都很熟悉。
不過,他表示,當背景同時開啟多個工作階段時,介面上常會出現多個相同標題的工作區,極易造成切換混淆。
為了解決手動修改標題的繁瑣步驟,作者決定開發一個名為 session-title 的自訂技能,設計為在回顧流程啟動時自動於工作區標題開頭加入 Emoji 圖示進行標註。在桌面版 Claude 中,修改標題可直接呼叫 MCP(Model Context Protocol)工具,但讀取當前標題則需讀取本地檔案系統。第一版技能共 78 行(約 4 KB),詳細說明了如何調用相關工具。
不過,當作者將工作流程搬移至雲端環境(Cloud Session)時,發現原本的改名功能失效。經檢查後確認,其實在雲端環境中,官方本身就提供了讀取與設定工作階段標題的兩組原生 MCP 工具。
為此,作者將技能擴充至 139 行(約 7.4 KB),企圖讓該技能同時相容桌面與雲端環境。
然而,這次擴充引發了他對於這個架構上的質疑:既然雲端原生環境已經具備現成的 MCP 工具,為什麼還需要額外注入 7KB 以上的技能文字去『教導』模型?這種冗餘的指令是否反而成了干擾?
為了驗證猜想,作者隨即在雲端環境針對「重新命名(任務 A)」、「加入 Emoji 前綴(任務 B)」與「單純讀取標題(任務 C)」三項操作進行了嚴格的自動化量化測試(Eval on Cloud):
| 測試任務 | 測試條件 | 平均快取讀取(Cache Read Tokens) | 額外消耗增幅 | 任務成功率 |
|---|---|---|---|---|
| A:重新命名 | 掛載自訂技能 | 311,582 tokens | +85.7% ⚠️ | 100% 成功 |
| A:重新命名 | 無自訂技能(原生) | 167,779 tokens | 基準線 | 100% 成功 |
| B:Emoji 前綴 | 掛載自訂技能 | 364,229 tokens | +58.2% ⚠️ | 100% 成功 |
| B:Emoji 前綴 | 無自訂技能(原生) | 230,194 tokens | 基準線 | 100% 成功 |
| C:讀取標題 | 掛載自訂技能 | 174,081 tokens | +11.6% ⚠️ | 100% 成功 |
| C:讀取標題 | 無自訂技能(原生) | 155,960 tokens | 基準線 | 100% 成功 |
測試數據令人大為震驚:無論有沒有掛載自訂技能,AI 都能 100% 順利完成任務;但在掛載他所開發的技能後,Token 消耗量卻飆升 50% 至 85%!
因此,自訂技能非但沒有提供任何加速價值,反而成了無謂霸佔上下文視窗(Context Rot)的昂貴包袱。
桌面端深度對照:精簡專用化才是正解
作者進一步在 Claude Desktop 本地環境進行深度對照。
實測顯示,在需要讀取本機檔案系統的場景下,自訂技能確實顯著降低了對話輪次與 Token 消耗;但在純粹的「重新命名」任務中,技能的存在反而讓對話輪次從 4 輪增加至 7 輪,Token 消耗翻倍。
這項結果證實了一項關鍵規律:模型本身就懂得如何調用 MCP 工具修改標題,技能中冗長複雜的說明就變成完全是畫蛇添足;唯一真正需要技能說明的,只有「桌面端如何從本地檔案系統讀取標題」這項模型原生缺失的能力。
因此,作者將該技能徹底重構為專門讀取標題的 get-session-title,剔除所有修改標題的廢棄指令,將代碼從 139 行大幅精簡至 29 行(約 1.3 KB):
| 桌面端測試項目 | 原始肥大技能(139行) | 精簡專用技能(29行) | 最佳化效益 |
|---|---|---|---|
| 重新命名(純寫入) | 7.00 輪 / 38.3 萬 tokens | 4.00 輪 / 20.3 萬 tokens | 對話輪次減少 43%,Token 砍半 |
| 讀取標題(純讀取) | 6.00 輪 / 26.9 萬 tokens | 5.00 輪 / 20.1 萬 tokens | 穩定維持極速讀取能力 |
如何避免 AI 技能在暗處退化?建立評估測試機制
如果沒有主動察覺異狀並展開量化評估,這類「任務雖然成功、但效能與成本大幅惡化」的隱性退化將長期侵蝕開發資源。
針對這項隱憂,作者引用 Anthropic 官方探討 Agent Skills 的架構,將 AI 技能劃分為兩大核心類別:
1. 能力提升型技能(Capability uplift skills):賦予模型原本不具備的特定操作能力或私有環境知識(例如:如何讀取本機特定內部檔案路徑)。
2. 編碼偏好型技能(Encoded preference skills):定義程式碼風格、命名規範或特定輸出排版偏好。
由於現在的模型已經不斷在進化,工具的生態也越來越成熟,以前我們建立的技能,很有可能已經在現代的模型架構下不再適用。因此,他也提出三項防範「技能退化」的建議:
- 最小干預原則:只為模型補足「真正欠缺的能力」,切忌用落落長的提示詞去重複教導模型早已內建的原生 MCP 工具。
- 強制導入評估機制:特別是針對「能力提升型技能」,應撰寫自動化測試腳本,定期測量掛載前後的對話輪次(Turns)與 Token 消耗變化。
- 動態汰除過期技能:隨著底層基底模型與工具生態快速升級,原本需要外掛技能補充的能力可能已被原生功能整合。開發者必須定期審查並果斷刪除過時技能,避免 AI Agent 陷入「越擴充越遲鈍」的技術泥淖。
新聞來源:kawasin73.hatenablog.com/entry/2026/08/24/171022
- 延伸閱讀:首例 AI 代理人「自主滲透」台灣政府!4 天攻破 85 組帳號、一路摸到核安會,近乎全自動攻擊架構曝光
- 延伸閱讀:AI 代理人闖禍!Cursor AI 9秒刪光新創公司生產資料庫,還「自白」認錯:我違反所有原則


請注意!留言要自負法律責任,相關案例層出不窮,請慎重發文!