

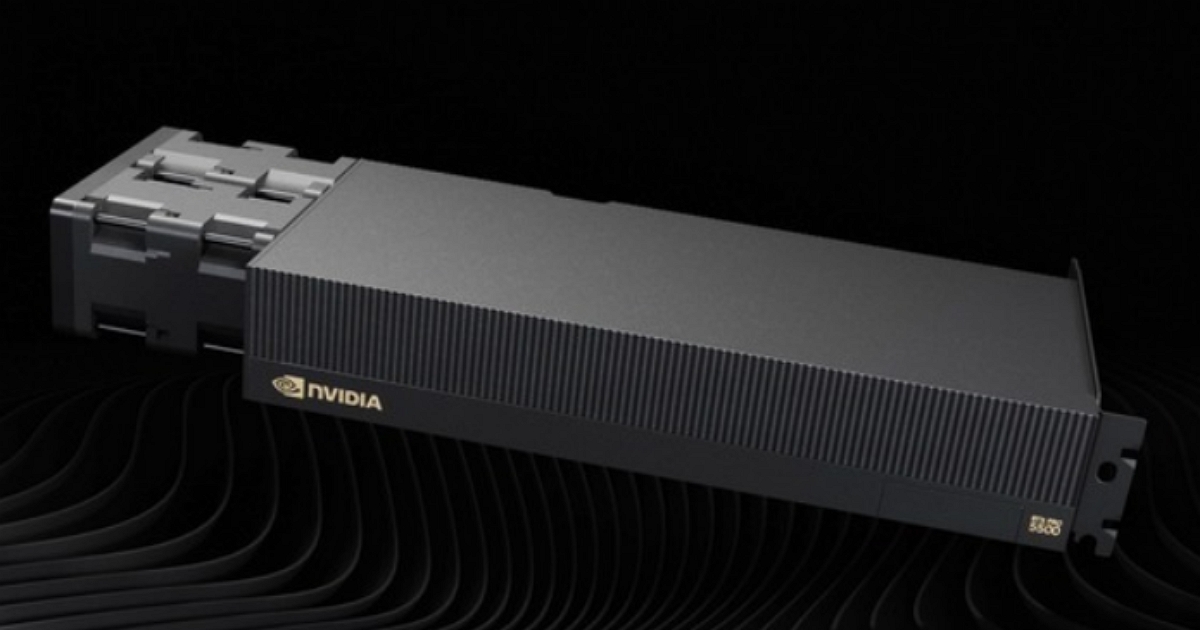
當頂級玩家還在緊盯 GeForce RTX 5090 的 32GB 顯示記憶體是否足夠因應次世代 3A 遊戲與各類工作負載時,NVIDIA 悄然揭曉了一張系出同源、但定位截然不同的怪獸級工作站繪圖卡——RTX PRO 5500 Blackwell Workstation Edition。兩者同樣具備 21,760 個 CUDA 核心,但 RTX PRO 5500 一口氣將 GDDR7 記憶體推升至驚人的 84GB,容量暴增達 2.625 倍。
21,760 CUDA核心配上 84GB GDDR7
從硬體核心架構來看,RTX PRO 5500 與遊戲旗艦 RTX 5090 幾乎流著相同的 Blackwell 血液。根據協力廠商 PNY 所公布的詳細規格,兩者皆採用台積電客製化 4N 製程、整合 922 億電晶體且晶粒面積達 750 mm² 的頂級晶片,並完整搭載 21,760 個 CUDA 核心、第 5 代 Tensor 核心與第 4 代 RT 核心。
然而,在最關鍵的記憶體配置上,NVIDIA 替 RTX PRO 5500 換上了支援錯誤訂正功能(ECC)的 84GB GDDR7,硬生生比消費端旗艦多出了整整 52GB。
這多出來的 52GB 記憶體並非單純的規格堆疊,而是為了讓企業能直接在本地端裝載超大型 AI 語言模型、拉長上下文視窗(Context Window),甚至在記憶體中同時駐留多套推論模型,免去以往必須頻繁將權重倒回系統主記憶體或固態硬碟的延遲瓶頸。
然而,超大容量並未換來全面的速度優勢,反而在數據傳輸上做出了妥協。RTX PRO 5500 採用 416-bit 記憶體介面,記憶體頻寬定在 1,398 GB/s;外媒 Tom's Hardware 明確指出,這項數據比遊戲卡 RTX 5090 低了大約 22%。更值得關注的是功耗,其整卡最大消耗電力從 RTX 5090 的 575W 進一步推升至 600W。顯然,在維持極大容量與企業級穩定性的前提下,NVIDIA 選擇犧牲部分極限頻寬,以換取能在長時繁重推論下維持穩定的運作餘裕。

告別個人桌面:從 MIG 虛擬化到機架式共享的算力集權
NVIDIA 在官方說明中特別強調,這張顯示卡主要鎖定企業級機架式工作站(Rackmount Workstation)部署。傳統上企業往往需要在每位工程師或設計師桌下配置昂貴的高階塔型主機,不僅佔用空間且產生大量廢熱;而透過機架式架構,企業能將運算節點統一把關在機房內,依據實際專案需求動態調配算力。
為了實現這種共享架構,RTX PRO 5500 導入了資料中心級別的「多執行個體 GPU」(Multi-Instance GPU, MIG)技術。硬體能將整張卡的 84GB 記憶體拆分為兩個各自獨立的 42GB 執行環境,並分別劃分專屬的記憶體、快取與運算核心。這意味著單一硬體節點可以無縫支援兩位工程師各自進行高強度的模擬或模型微調,彼此運算任務互不干擾,有效避免了昂貴 GPU 資源處於閒置狀態的浪費。
在 PRO 5000 與 6000 之間精準卡位
硬體新聞媒體 VideoCardz 分析指出,RTX PRO 5500 本質上是填補 RTX PRO 5000 與頂級旗艦 RTX PRO 6000 之間市場空白的精準棋子。相較於坐擁 24,064 個 CUDA 核心與 96GB 記憶體的極限卡王 RTX PRO 6000,RTX PRO 5500 在核心數與記憶體上分別縮減約 9.6% 與 12.5%,但在同樣 600W 功耗框架下,無疑為預算敏感卻急需大記憶體的企業客戶提供了一條折衷路徑。
這項佈局也引發了外媒 Tom's Hardware 的犀利評價。該媒體直言,面對當前高利潤的 AI 算力需求,遊戲業務無疑「退居次要地位」;NVIDIA 將原本可用於高階 GeForce 遊戲卡的晶片資源,藉由大容量 GDDR7 與專業認證重新包裝,轉化為能夠攫取超高毛利的工作站金雞母。
目前 NVIDIA 官方頁面僅標記該產品「即將推出」,尚未公開確切發售日期與官方定價。但可以預見的是,在大型語言模型與專業數位雙生技術全面普及的當下,這張具備 84GB 記憶體的工作站怪獸,將成為許多無法負擔整座伺服器叢集、卻又受困於消費級顯卡記憶體上限的企業團隊,最受矚目的在地部署新選項。
- 延伸閱讀:祖克柏變身 AI 地主!Anthropic 傳向 Meta 租輝達 H100 與新一代 Blackwell 算力
- 延伸閱讀:黃仁勳爆猛料!NVIDIA最強Blackwell、Rubin晶片也要賣中國市場,否則就等華為超車
- 延伸閱讀:【CES 2026】Lenovo 首創外折捲軸螢幕筆電、內建 NVIDIA Blackwell 的個人 AI 中心


請注意!留言要自負法律責任,相關案例層出不窮,請慎重發文!