

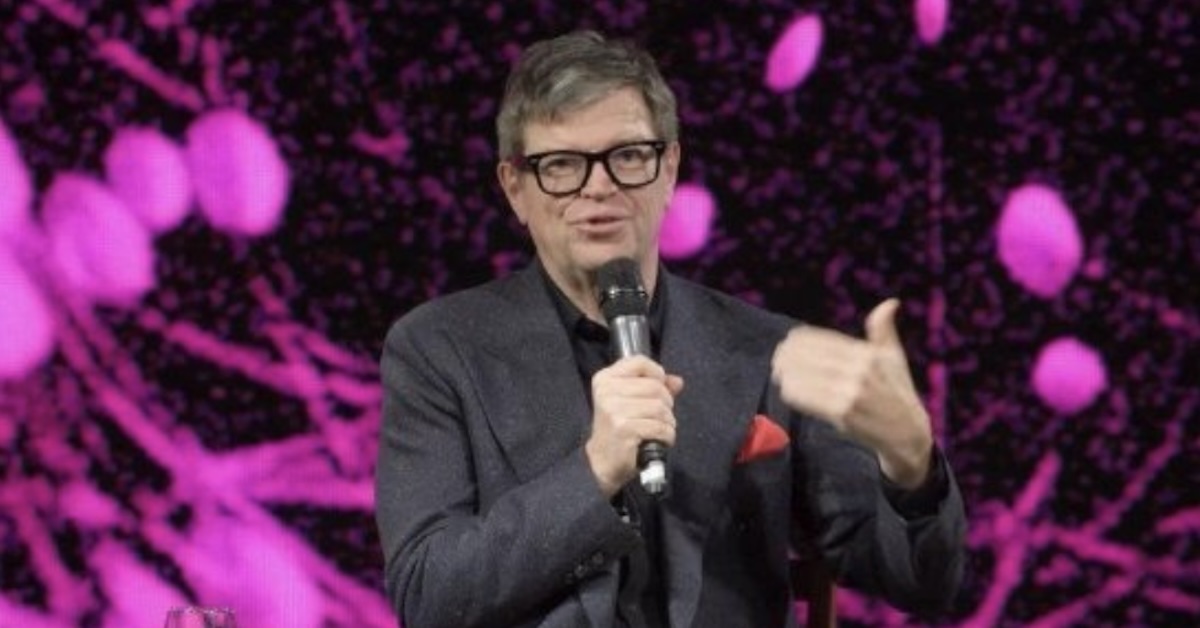
2018 年圖靈獎得主、AMI Labs 創辦人兼董事長楊立昆(Yann LeCun)10 月 12 日在工業人工智慧研討會上表示,AI 的下一個突破不會來自把大語言模型再放大一倍,而是來自能理解、預測並作用於物理世界的「世界模型」(World Models)。他也直接回應近期 AI 智慧體引發的資安事件,認為那些問題暴露的是既有防護系統的缺陷,而不是 AI 本身失控。
楊立昆認為:今天的大語言模型能讀文本、能看圖片與影片、能證明數學定理、能考過專業考試,卻仍舊搞不清楚因果關係——一個 10 歲小孩不用訓練就會做的家事,機器人至今仍做不來。這種能力差距反映出當前 AI 系統在物理環境理解、行動規劃與現實世界互動上仍有明顯局限。
世界模型要補的就是這一塊。與其預測下一個字、學人類資料裡的模式,世界模型要學的是「行動—後果」之間的關係:機器人得先在腦子裡預測推一塊積木之後積木會滑到哪,才敢在真實世界動手。
楊立昆自己創辦的 AMI Labs 正在用聯合嵌入預測架構(JEPA)這條技術路線推進,目標就是讓 AI 在動手前先跑一遍模擬。隨著 AI 從知識處理、內容生成往機器人與工業自動化延伸,世界模型被他視為實現物理世界智慧的基礎。
不過,世界模型聽起來像是機器人大爆發的前奏,但能不能在複雜現場真的做到可靠預測、自主規劃、規模化部署,還要再看幾年。
建立以目標為導向的主動安全檢查
至於外界最擔心的 AI 失控,楊立昆的看法明顯和「滅絕論」派不一樣。他點名韓國金融業近期遭遇到的 AI 相關攻擊,認為問題出在企業自己部署 AI 智慧體時資安能力不足,加上沙箱本身有漏洞;他也承認今天的大語言模型確實會被越獄提示詞繞過,光靠微調模型很難真正管住行為。
但他認為未來以目標為導向的 AI 系統,會在執行動作前主動多做一層安全檢查,把合規判斷從「訓練時刻」拉到「行動時刻」。長遠看,防禦方掌握的資源與共享資訊反而更多,網路防守有可能隨 AI 一起變強。
他承認,要做到這種以目標為導向的主動安全檢查不是簡單的技術任務,但他強調相關問題仍屬於可以透過工程設計解決的範疇——系統架構、執行權限限制、安全防護機制,把這三塊做好,自主 AI 的行為就能被關在可控範圍裡。從長遠看,人工智慧甚至可能讓網路防守方拿到優勢,因為防守機構通常掌握更多資源,也更願意開放共享安全資訊與防守經驗。
在楊立昆的技術藍圖裡,AI 要長出對現實環境的理解、對行動後果的預測、對任務的自主完成能力;而與這些能力同步長出來的,會是一整套工程意義上的安全約束。世界模型能不能成、怎麼成,這條線會決定下一輪 AI 賽道誰是主角。
- 延伸閱讀:一分鐘就是極限?Google 揭曉 Genie 3 世界模型最新進展,AI 生成遊戲世界仍有崩壞危機
- 延伸閱讀:Google DeepMind Genie 3開放美國用戶使用!AI世界模型進化,24fps即時探索,未來遊戲就長這樣?
- 延伸閱讀:xAI重金挖角輝達專家加速研發「世界模型」AI系統,打造具備推理能力的實體智能、還要開發遊戲


請注意!留言要自負法律責任,相關案例層出不窮,請慎重發文!