

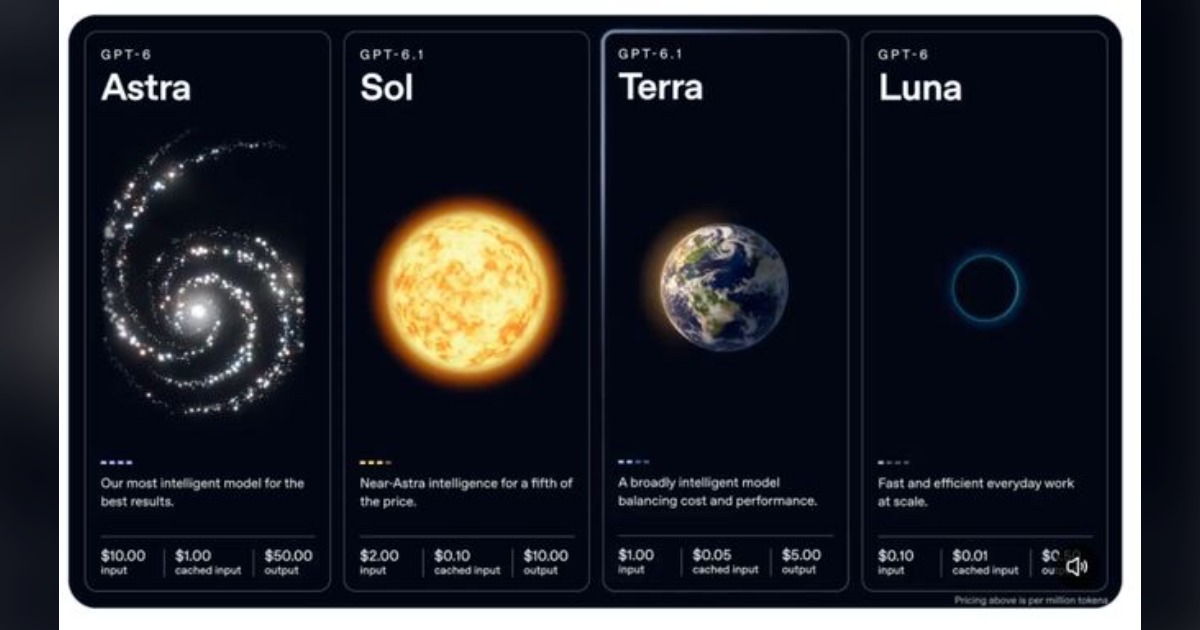
OpenAI 正式發表全新中階主力模型「GPT-6.1 Terra」,執行長阿特曼(Sam Altman)興奮宣告該模型將開啟電腦自動化操作的全新時代,主打以極致性價比承接起草專案企劃、解讀工程圖面、表格資料登錄及影片剪輯等日常生產力任務。
新模型即日起全面向 ChatGPT Work 與 Codex 的付費用戶開放,API 調用代號為 gpt-6.1-terra。其標準 API 輸入定價為每百萬 Token 1 美元、快取輸入 0.05 美元、輸出 5 美元,相較上一代直接降價 50%,大幅降低企業打造自動化流程的門檻。

電腦操作比肩頂級旗艦
在評估智慧體操縱電腦能力的權威基準 Agents' Last Exam 中,中等推論強度下的 GPT-6.1 Terra 得分比前代 5.6 Terra 暴增 15 個百分點,成本卻僅需三分之一;其綜合表現更已逼近最頂級的 GPT-6 Astra,而呼叫價格僅為其十分之一。
而在最高推論強度設定下,Terra 的 Token 消耗效率達到 Anthropic 頂級模型 Claude Opus 5.5 的三倍以上,加上每單位 Token 僅需對手四分之一價格,使完成相同專業任務的整體運算開銷直接銳減至約九分之一。
除了價格優勢,Terra 的反應節奏亦大幅進化,實際任務執行速度足足達到 GPT-6 Astra 與 6.1 Sol 的三倍以上。
在視覺推論基準 MMMU-Pro 與桌面操作測試 OSWorld 2.1 項目中,Terra 均全面壓制 5.6 Terra,展現從判讀工程設計圖到自動建立 3D 模型的高階多工實作潛力。
大幅壓低事實幻覺率,終端程式碼解題能力翻倍暴增
針對大型語言模型為人詬病的事實幻覺,OpenAI 內部測試顯示,在容易誘發錯誤的嚴苛提示詞情境下,低推論強度的錯誤率從前代的 53.6% 驟降至 16.7%;在最高強度下錯誤率更僅剩 4.3%,幾乎看齊頂級旗艦。
程式碼開發方面,在評估命令列除錯能力的 Terminal-Bench 4.0 測試中,GPT-6.1 Terra 能成功解決 50.3% 的任務,成績比 5.6 Terra 的 21.5% 翻倍成長。
在考驗科學研究程式編寫的 Terminal-Bench-Science 測試中,其高強度得分甚至超越了高階的 GPT-6.1 Sol,距離 Opus 5.5 僅差不到 5 個百分點,預估部署成本卻不到對手五分之一。
資安防護方面,OpenAI 準備度框架將其網路安全評定達到關鍵(Critical)等級,具備更強大的提示詞注入攻擊防禦力,並能在執行中誠實告知自身極限,兼顧自動化威力與對齊安全。
- 延伸閱讀:OpenAI 與 Anthropic 被爆正在閉門推演「AI 崩潰」劇本:若導致大規模斷水斷電,高層該如何面對公關危機?
- 延伸閱讀:Atlas退場後,OpenAI把ChatGPT塞進了你現在用的瀏覽器
- 延伸閱讀:ChatGPT生成圖竟直接冒用畫家簽名,OpenAI被控「身分竊盜」惹怒《紐約客》名家


請注意!留言要自負法律責任,相關案例層出不窮,請慎重發文!