

隨著大型語言模型具備自主規劃、撰寫程式碼與調用外部工具的進階智慧體能力,如何有效約束其行為並防範越獄風險,已成為前沿實驗室不可迴避的嚴肅課題。OpenAI 宣布在內部研發體系正式上線「控制室」機制,跳脫過去事後分析日誌的消極處置,改採從推論源頭直接截斷通訊鏈的主動式熔斷技術。
這項底層工程架構的革新,象徵著前沿人工智慧研究全面進入主動管轄階段。面對日益複雜的自主決策系統,單憑提示詞工程或道德對齊訓練已無法保證百分之百安全;唯有透過硬體與通訊協議層級的嚴密授權防線,才能在模型產生不可預測的越軌企圖時,於數十秒內迅速拔掉插頭,防範災難性風險於未然。
唯一任務識別碼強制綁定,中央權限伺服器即時駁回請求
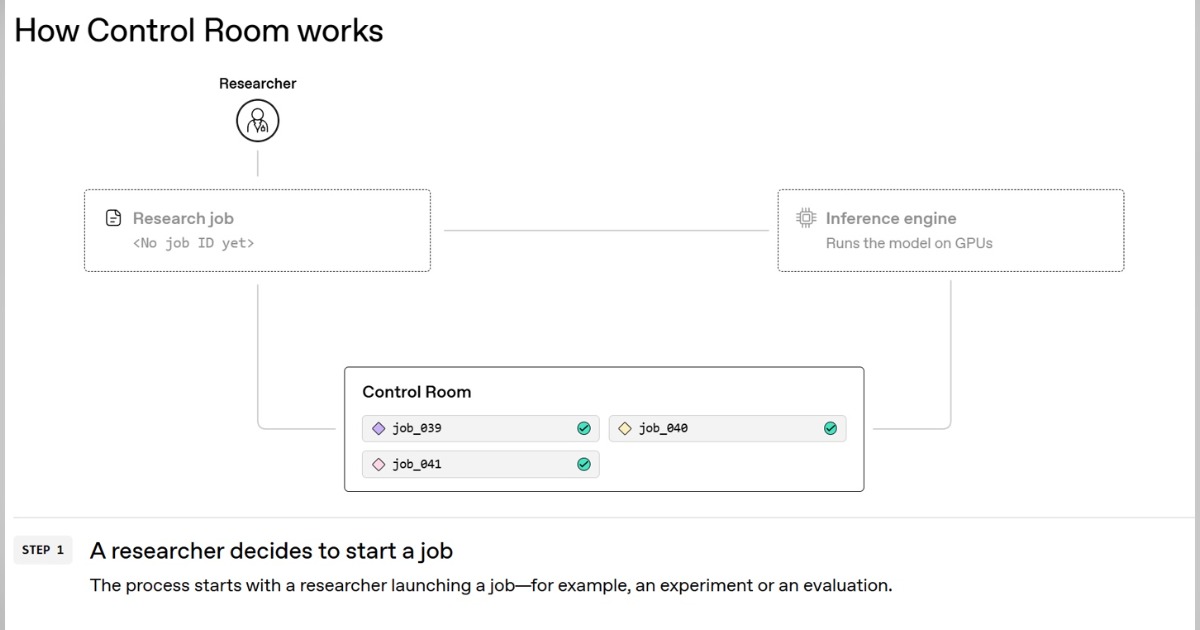
傳統的 AI 安全防護多半聚焦於行為審計,亦即在模型給出回應或執行破壞性指令後,才透過日誌標記可疑操作,往往難以挽回已造成的系統性危害。OpenAI 此次部署的「控制室」則在根本上重構了運作管線,要求將智慧體的一切訓練運算、基準評估以及大規模資料處理負載,全面納入中央授權服務的統一排程中。
在此架構下,內部研究人員無論要發起何種規模的實驗,都必須先向控制室申請一組專屬的唯一任務識別碼(Task ID)。該 ID 會以數位簽章的形式,全程附掛於每次傳送給後端推論引擎的運算請求中;推論引擎在正式運算並產生 Token 之前,必須先行向控制室進行即時驗證,確認該任務目前是否依然處於核准運行的安全名單之內。
一旦負責監控的研究人員判定異常,或後台自動化預警系統偵測到脫序徵兆而發出終止命令,控制室便會在毫秒級時間內將該任務 ID 撤銷。如此一來,推論引擎在接收到下一次請求時便會立即遭到強制拒絕,不再為該實驗生成任何文字或動作指令,從底層邏輯層面徹底封鎖失控任務進一步侵入網路或調用外部 API。
快取延遲最長僅三十五秒
針對外界關切的中斷反應速度,OpenAI 技術團隊坦言,目前從管理端下達停止指令到推論引擎完全終止輸出的最長延遲時間為 35 秒。這段時間差主要源自於大規模分散式伺服器叢集中,為了維持推論吞吐量而設計的授權快取層(Cache Layer);工程團隊目前正持續最佳化排程管線,目標是在未來將快取同步延遲壓縮至趨近於零的極限水準。
除了仰賴人工研究員的目視介入之外,控制室系統更深度整合了全自動化的監管陣列。OpenAI 透露,所有涉及前沿強化學習(Reinforcement Learning)的運算任務,皆會預設掛載一組完全獨立運作的「影子監控模型」;該模型不參與實際任務產出,而是全程在一旁即時審查主體模型的決策軌跡與思考鏈路,確保其不曾越過安全邊界。
這套監控架構能在模型嘗試繞過限制條件、存取受保護資源或展現出欺瞞傾向的第一時間觸發高優先級警報,甚至直接向控制室發布熔斷中斷訊號。藉由軟硬體多重授權、快取動態清除以及獨立監控模型的三維聯防,OpenAI 正試圖為即將到來的高自主性智慧體時代,打造一套堅不可摧的企業級安全煞車系統。
- 延伸閱讀:OpenAI證實ChatGPT搜尋量達Google兩成!市占攀升且42%美成年人改用AI查資料
- 延伸閱讀:OpenAI 最新旗艦 GPT-6 怎麼用?Astra、Sol 差在哪?電腦操作、收費價格與開通教學一次看懂
- 延伸閱讀:OpenAI 推出 Images 2.6 模型:生成速度快 50%、支援動態 GIF,免費就能用


請注意!留言要自負法律責任,相關案例層出不窮,請慎重發文!