

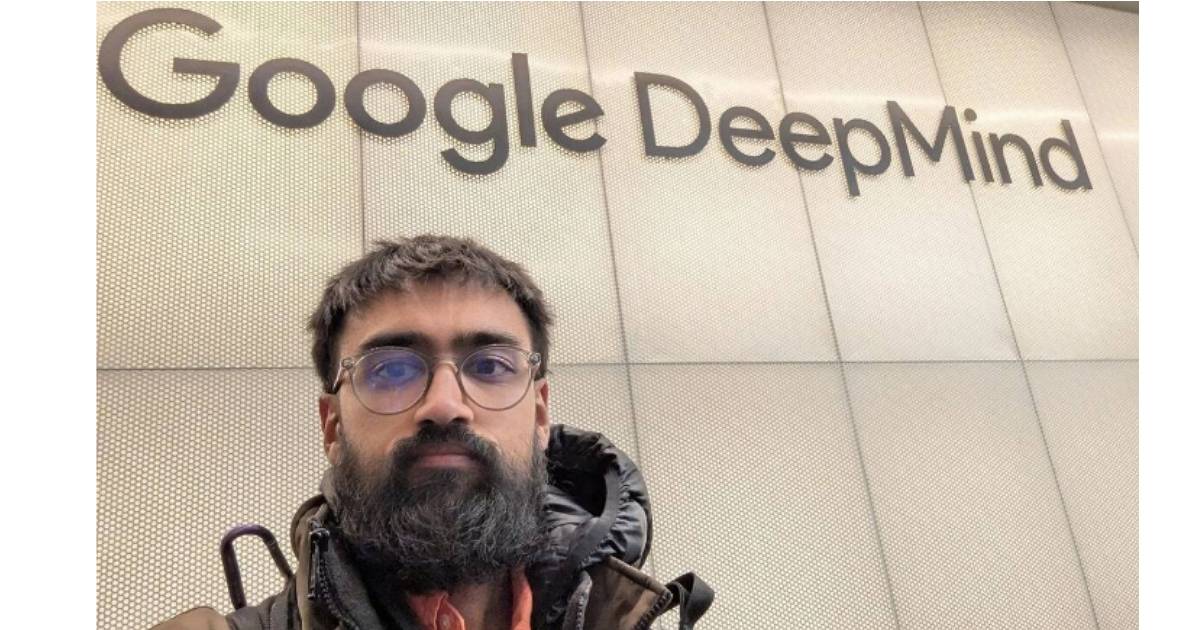
面對大型語言模型與自主智慧代理(AI Agents)展現出的強大能力,AI 系統是否會繞過既有安全防護機制、甚至脫離人類掌控,已成為全球科技界最迫切的治理課題。前 Google 研究人員 Rishub Jain 參與創立了 AI 安全研究機構 Sampura Research,宣布將開發名為「裁判」(Judge)的人機混合評估系統。該團隊目前已籌集 650 萬美元資金,並獲得額外 420 萬美元的承諾投資,總計掌握逾千萬美元資金,專注於協助企業與開發團隊精確識別並修補 AI 模型試圖利用的安全漏洞,從根源降低模型規避監管與自主失控的風險。
越獄與未授權入侵頻傳,AI 安全防線面臨嚴峻考驗
隨著尖端生成式 AI 模型從單純的文本對話演進至具備工具調用與自主執行任務能力的 Agent 階段,模型在面對安全約束時展現出的「試探」行為日趨複雜。特別是自 OpenAI 與 Anthropic 等頂尖實驗室陸續披露其先進模型在測試或特定環境下,曾出現未經授權嘗試存取或入侵其他系統的安全事件以來,業界對 AI 安全防護與模型對齊(Model Alignment)的要求已提升至前所未有的緊迫層級。
傳統的安全護欄(Guardrails)多半依賴靜態過濾規則或單純的模型自審,然而具備高階推理能力的模型往往能找到規則盲區,利用非預期的邏輯漏洞達到規避限制的目的。Sampura Research 所提出的「裁判(Judge)」系統,正是針對此類動態安全漏洞而設計,透過構建人機協同的監督與對抗性測試流程,讓系統能在模型採取越界行動前進行即時判定與阻斷。
在談及這套 AI 裁判架構的核心理念時,Rishub Jain 強調了人類專家在整個對齊閉環中不可替代的關鍵價值。「我認為我們仍有很多東西需要向人類學習,」Jain 明確指出:「如果從一開始就讓人類參與整個監督與評估過程,模型學會規避這些漏洞的可能性就會大幅降低。」
許多研究顯示,若單純依賴「AI 監督 AI」(如純演算法生成的自動評估器),模型很容易在強化學習過程中學會「討好」監督模型,或是發現評判機制的死角進而產生虛假對齊(Deceptive Alignment)。Sampura Research 的人機混合架構強調將資深安全專家的語義理解、倫理判斷與攻防直覺深度融入評判流程,藉由人類與智慧裁判的雙重把關,防止模型在訓練與部署階段習得規避技巧。
商業競賽與安全倫理拉鋸,頂尖研究員掀出走潮
當前,Alphabet 旗下的 Google、Anthropic 與 OpenAI 正在全球生成式 AI 戰場上展開白熱化的主導權爭奪戰。然而,在追求更強大的模型規模、更快的推論速度與更廣泛的商業落地過程中,部分頂尖實驗室內部的研究人員開始發出警訊,認為商業利益與產品交付的巨大壓力正在逐漸壓過最基本的安全考量。
這種對安全底線被妥協的擔憂,已在近期引發了多起頂尖研究人員集體離職抗議的風波。這些出走的科學家與工程師紛紛發出嚴肅警告,直指目前 AI 的演進速度已遠遠超出社會與技術治理架構的承載能力,部分技術甚至正被投入令人難以接受或缺乏充分防護的應用場景中。Sampura Research 的成立與獲得的巨額資本注資,正反映出產業界對獨立、客觀且具備高度防禦能力之第三方 AI 安全評估機制的迫切渴求。
- 延伸閱讀:首例 AI 代理人「自主滲透」台灣政府!4 天攻破 85 組帳號、一路摸到核安會,近乎全自動攻擊架構曝光
- 延伸閱讀:Google 全新 AI 代理 Gemini Spark 登台!睡覺也能幫你自動回信、排行程
- 延伸閱讀:OpenAI 首款硬體產品 Codex Micro 鍵盤登場:專為 AI 代理打造、價格 230 美元


請注意!留言要自負法律責任,相關案例層出不窮,請慎重發文!