

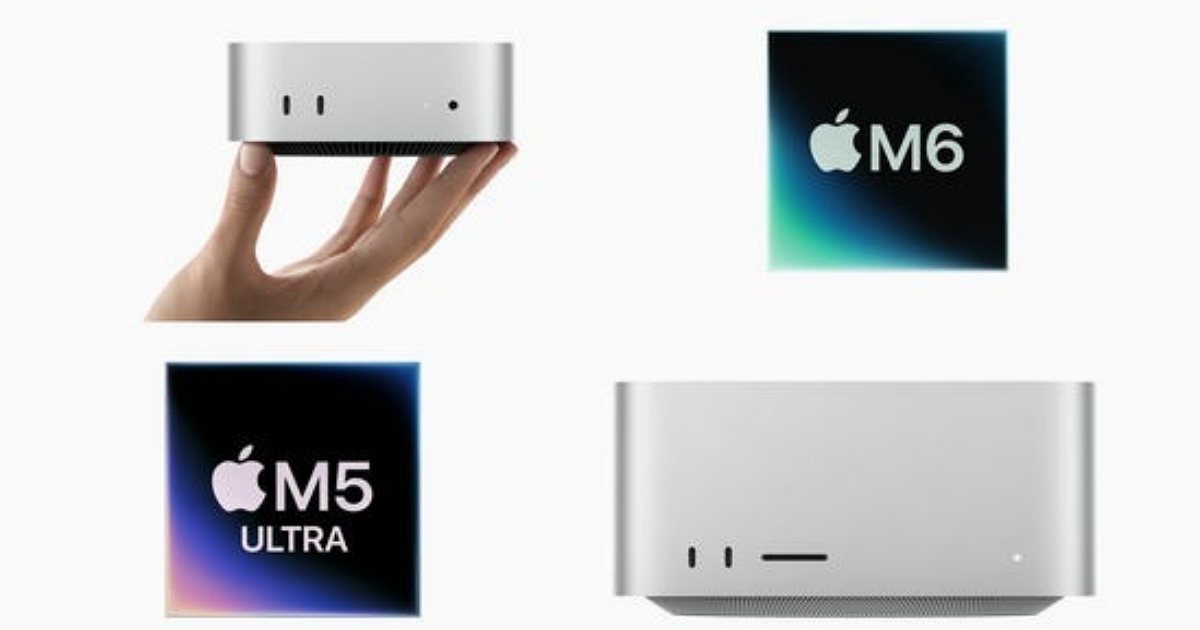
根據科技外媒披露,生成式 AI 巨頭 OpenAI 近期已大舉採購數萬台蘋果 Mac mini 與 Mac Studio 裝置,將其投入強化學習訓練與電腦操作代理(Computer-Use Agents)的龐大算力池中。
與此同時,競爭對手 Anthropic 亦被揭露透過亞馬遜 AWS(Amazon Web Services)大量租用 Mac 運算實例。蘋果憑藉 Apple Silicon 獨特且強大的「統一記憶體架構(Unified Memory Architecture)」,意外在頂尖 AI 研究機構與雲端工作負載中脫穎而出,成為 AI 代理編排與分散式推論的新一代熱門硬體平台。
傳統 PC 與伺服器運算架構中,中央處理器(CPU)與圖形處理器(GPU)的記憶體完全獨立分開,當 GPU 需要處理龐大的大語言模型權重時,必須頻繁透過 PCIe 匯流排從系統主記憶體複製資料至顯存,匯流排頻寬往往成為整體運算效能的致命瓶頸。
然而,蘋果 Apple Silicon 採用的統一記憶體架構徹底打破了這項物理藩籬,CPU、GPU 與神經網路引擎(Neural Engine)共享同一塊超高頻寬、低延遲的記憶體池,GPU 能夠直接存取龐大模型資料而無須任何額外複製開銷。
這項架構優勢讓 AI 企業得以透過次世代高速傳輸技術(如 Thunderbolt 5 結合 RDMA 技術),將多台高階 Mac 串接成擁有數百 GB 乃至超過 1.5TB 統一顯存池的微型 AI 運算叢集,以極具性價比的成本高效運行超大型開源模型與複雜的智慧代理編排(Agent Orchestration)任務。
蘋果 Mac 部門營收暴增 29%:從開源社群 OpenClaw 到 AI 資料中心的新黑馬
這股源自 AI 研發端的強勁硬體需求,直接反映在蘋果的財務數據上。
蘋果 2026 年第三季財報顯示,Mac 部門營收較前一年同期大幅成長 29%,顯示蘋果在 AI 邊緣運算與開發者硬體市場上的滲透力遠超外界預期。事實上,AI 運算社群對 Mac 硬體的青睞最早可追溯至熱門開源專案「OpenClaw」的推波助瀾;如今,不僅 OpenAI 與 Anthropic 等一線 AI 大廠將 Mac 納入核心研發架構,更有新創團隊開始專門採用高階 Mac 伺服器叢集打造次世代 AI 資料中心。
特別值得注意的是,蘋果近期發布了搭載 M6 晶片的新款 Mac mini 與搭載 M5 Ultra 晶片的新一代 Mac Studio,其中 M5 Ultra 最高可配置高達 512GB 的統一記憶體,使研究人員能夠在本機端完整加載並運行過去僅能在頂級伺服器叢集運行的龐大 AI 模型。
科技媒體 Wccftech 與產業分析師普遍預估,新一代 M 系列晶片的問世將引發全球頂尖 AI 研究實驗室與企業開發團隊另一波龐大的硬體升級換機潮,進一步確立蘋果在 AI 代理開發、本地端微調與強化學習環境中的關鍵硬體標準地位。
輝達 RTX Spark 筆電晶片首批秒殺,華碩與微星追單搶貨
這場由 AI 代理與邊緣運算驅動的硬體需求爆發,並非僅由蘋果獨占鰲頭。
在 Windows 與 PC 伺服器陣營方面,晶片巨擘輝達(NVIDIA)專為 AI 運算與次世代筆電打造的全新 Arm 架構晶片「NVIDIA RTX Spark」(以及 N1 / N1X 運算平台)首批出貨配額同樣在市場上被搶購一空。包括台灣科技大廠華碩(ASUS)、微星(MSI),以及 Dell、HP、聯想(Lenovo)與微軟(Microsoft)等全球一線品牌廠,皆全力搶進這波邊緣 AI 硬體商機,爭相包下首批 N1X 系統產能。
根據《經濟日報》報導,華碩與微星在產品發布初期便迅速消化完所有的第一批晶片配額,目前正積極向輝達爭取額外供貨,以滿足全球企業與頂級玩家對本地端 AI 高效能運算設備的飢渴需求。從蘋果統一記憶體的 Mac 叢集到輝達次世代 Arm 架構 AI 處理器,整體科技產業的硬體競爭已從傳統的純算力 TFLOPS 比拼,全面轉向高記憶體頻寬、大容量架構整合與邊緣 AI 代理執行效率的全新戰場。
- 延伸閱讀:Apple Silicon iMac 設計內幕曝光:螢幕下方蘋果標誌原本差點回歸?
- 延伸閱讀:蘋果高層回顧自研Apple Silicon晶片歷程,表示是場豪賭「我們沒有Plan B 」
- 延伸閱讀:傳蘋果正在大力投資 NVIDIA 伺服器以開發人工智慧,自家的Apple Silicon 伺服器不夠用?


請注意!留言要自負法律責任,相關案例層出不窮,請慎重發文!