

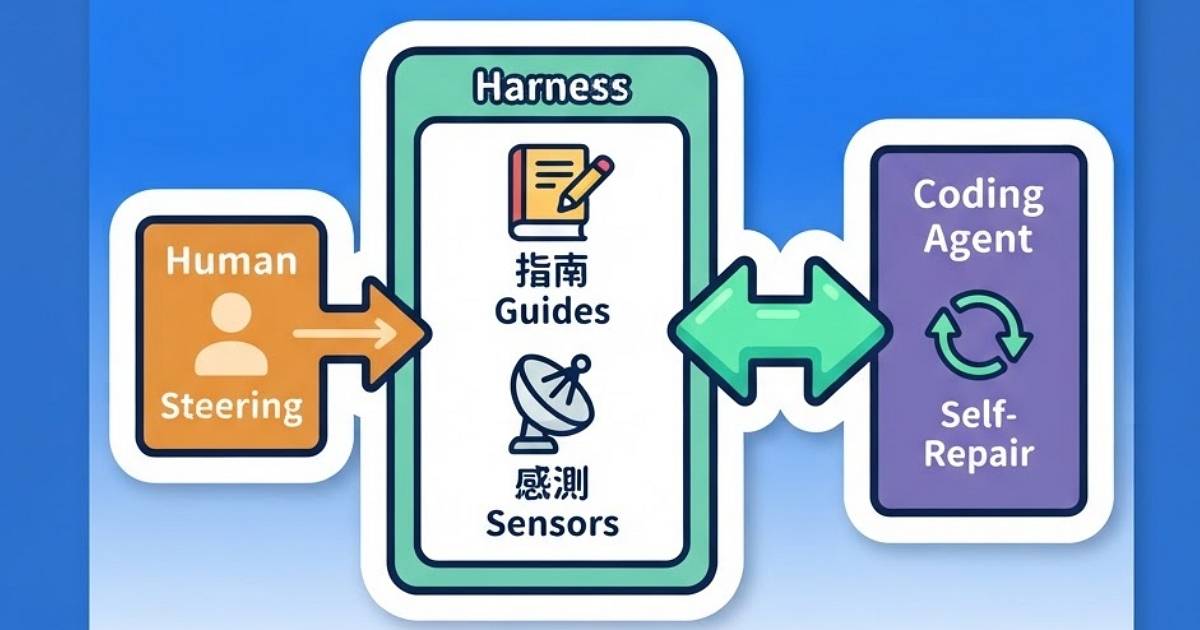
隨著以 AI 為核心的自動程式代理(AI Coding Agent)在現代軟體開發流程中扮演日益關鍵的角色,開發團隊究竟能在多大程度上信任 AI 生成的程式碼,已成為決定工程生產力上限的核心課題。
知名軟體設計專家暨 Thoughtworks 資深技術專家 比爾吉塔·貝克勒(Birgitta Böckeler)近期發表深度專文指出,若要真正釋放 AI 智慧體的協作潛力,關鍵不在於盲目升級基礎大語言模型(LLM),而是必須為 AI 構建一套嚴密且可持續演進的周邊協作運行體系——即所謂的Harness Engineering。
在現代軟體工程體系中,「Harness」本質上是將 AI 模型與精準指令、外部工具鏈及自動化驗證機制深度結合的運算框架。業界普遍將新一代 AI 助理定義為「AI Agent = AI 模型 + Harness」。

若將大語言模型視為負責語意理解與邏輯推理的大腦核心,Harness 就是引導模型將思考精準轉化為可用軟體資產的骨骼與神經網絡。儘管市售 AI 編程代理往往內建了基礎的安全帶機制,但軟體團隊若要真正解決專案落地時的幻覺與重複出錯問題,就必須由工程團隊親自針對特定系統架構量身打造外部的定制化安全帶機制。
從「指引(Guides)」到「感測(Sensors)」建構自我修復循環
AI 編程代理之所以頻繁重複踩坑,根本原因在於大型語言模型天生缺乏人類資深工程師在團隊中所累積的歷史經驗。人類工程師能直覺判斷「某段邏輯過去曾引發線上事故」、「此架構未來極難重構維護」或「該模組必須遵循特定的命名與分層慣例」,但這些深植於團隊文化中的直覺判斷,並不會自動載入至通用 AI 的上下文視窗中。
為此,Böckeler 將Harness工程的核心支柱拆解為兩大協同機制:「指引(Guides)」與「感測(Sensors)」。
「指引」機制聚焦於作業前的事前規則注入,涵蓋專案特定的架構設計方針、編碼風格規範、API 調用白名單以及標準工作流程(SOP),確保 AI 在動筆編程前獲得充足的邊界約束;而「感測」機制則專注於作業後的事後自動檢驗,透過單元測試、靜態代碼分析(Linter)及編譯器反饋動態抓取邏輯缺陷與漏洞。
單純仰賴 Guides 會讓開發者陷入難以即時驗證產出的被動狀態,而僅有 Sensors 則可能導致 AI 陷入盲目試錯的死循環。唯有將兩者結合成有機閉環,讓 AI 犯錯時能立即捕獲感測器的異常日誌並基於指引自主修復,方能打造出高韌性的自主編程流程。
架構適配與可維護性治理:超越單次修補的持續工程化演進之道
在具體範疇上,安全帶工程主要圍繞三大核心維度展開維護:程式碼的可維護性(Maintainability)、架構適配度(Architecture Fitness)以及軟體行為的精準度(Behaviour)。
Böckeler 特別示警,當團隊發現 AI 代理在某個架構模組上反覆出現類似的實作偏差時,最糟糕的做法莫過於工程師每次都默默手動改掉代碼;這種「單次補破網」的思維只會讓技術債持續累積。標準的工程化實踐應是將每次 AI 的失敗案例視為架構感測器的升級契機,藉由更新 Guides 的約束條款或在 Sensors 中新增專案級別的自定義檢查規則,讓錯誤在機制層面被永久阻絕。
儘管自動化安全帶系統能夠大幅吸收語法檢查、型別驗證與常規單元測試等繁重負荷,但 Böckeler 亦客觀指出,並非所有軟體維度都能以演算法或靜態規則完整涵蓋,諸如「終端使用者核心體驗是否符合商業價值」或「業務邏輯的深層意圖取捨」等高階決策,依然仰賴人類資深工程師的專業審查。安全帶工程的終極價值,在於將軟體團隊長年累積的暗默工程經驗萃取為可執行的規則庫,在最大化 AI 自主檢查與自我修復覆蓋率的同時,將寶貴的人力認知資源重新釋放並聚焦於最核心的系統架構與產品創新之中。


請注意!留言要自負法律責任,相關案例層出不窮,請慎重發文!