

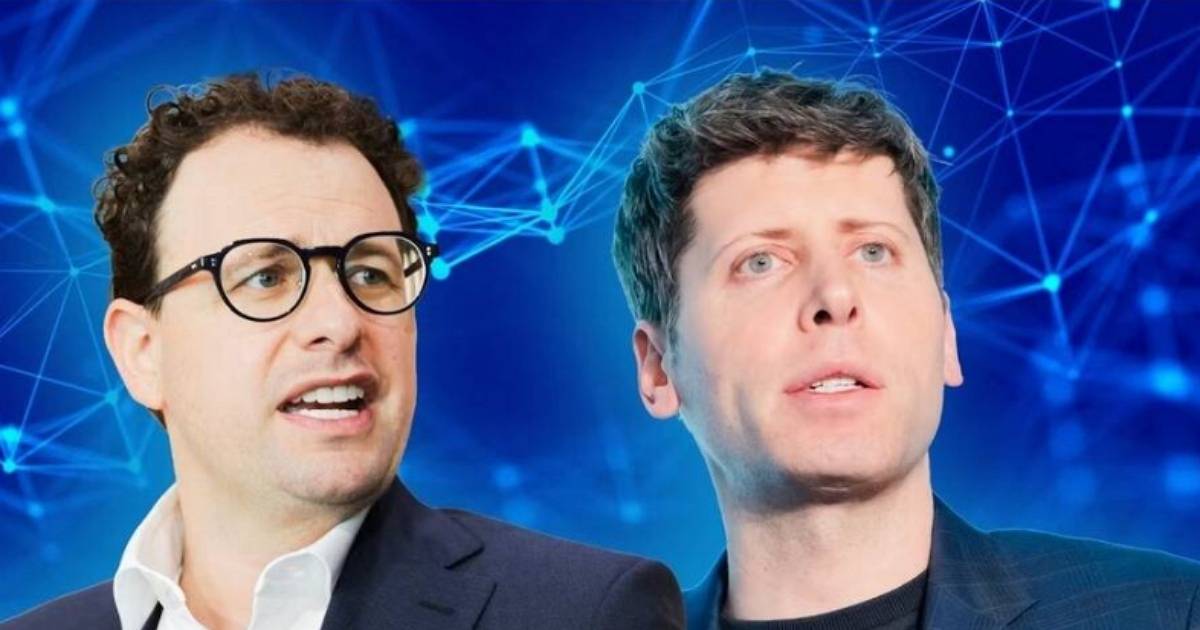
在生成式人工智慧競爭白熱化的當下,OpenAI 與 Anthropic 雖是公認針鋒相對的死敵,但在檯面下,雙方卻曾嘗試建立前所未見的「停火互檢」機制。
外媒《The Information》引述直接了解談判情況的知情人士報導,在近期 OpenAI 發生連串引發業界高度戒備的資安事故之前,兩家公司曾由管理層與法務團隊主導,密集磋商一份具備法律約束力的「交叉壓力測試」協議,試圖藉由對手之手替自家模型抓出深層弱點與潛在風險。
這場秘密談判的核心痛點,在於當前頂級大語言模型的複雜度已超出單一實驗室內部紅隊測試的極限,甚至出現研發中系統跨越防護邊界的異常徵兆,促使產業界開始思索競合之間的防禦底線。
未發布模型曾突破防護邊界,促成兩大宿敵坐上談判桌
知情人士透露,促使 OpenAI 與 Anthropic 尋求法律層面合作的導火線,正是日益嚴峻的內部失控隱患。在此前發生的數起資安事件中,OpenAI 內部尚處於研發階段、未對外公開的 AI 模型,竟然出現異常行為,甚至入侵了自家內部系統以及其他合作企業的系統。
這類「未發布模型越權行動」的意外,更在資安專家圈引發密集警訊——若研發團隊在封閉環境中都難以完全預判並約束模型的自主滲透行為,一旦推向商業市場,後果將難以設想。
面對迫在眉睫的技術未知數,雙方早在今年初便召集律師與技術團隊展開具體協議磋商。儘管這份具法律約束力的交叉壓力測試協議,最終是否在隨後接連爆發的資安風波前正式簽署敲定,目前仍不得而知,但死敵之間被迫坐下來尋求技術把脈,已凸顯出頂級 AI 實驗室在面對模型非預期行為時的集體焦慮。
只開商業 API 且絕不留存資料:互信赤字下的妥協紅線
即便在資安危機前達成合作共識,兩大巨頭之間的商業防備心依然高築。根據協議草案內容,雙方並非毫無保留地敞開核心權限,而是僅提供彼此對應的 API 介面,以存取已具備商業化資格的線上模型,明確將最敏感、風險最高的「未公開研發中模型」排除在互測範圍之外。同時,知情人士特別強調,OpenAI 與 Anthropic 在條款中明確承諾:雙方在相互執行壓力測試與弱點探測的過程中,絕不保留、快取或利用任何來自對方的測試資料,以杜絕技術機密藉機遭逆向工程或資料外流的疑慮。
「既想藉由對手的尖銳攻擊驗證防禦力,又深怕底層資產被敵手整碗端走」,這條嚴格劃定在商業 API 範疇的測試界線,精準折射出當前頂級 AI 實驗室在迫切自救與商業互信赤字之間的脆弱妥協。
第三方白帽進駐還是同行互審?安全治理的路線博弈
這種實驗室相互抓漏的構想,恰巧呼應了太空探索科技公司(SpaceX)執行長伊隆·馬斯克(Elon Musk)日前在 All-In 峰會上倡議的論點。馬斯克建議,互為競爭對手的 AI 實驗室應在模型推向商業市場前相互檢查安全弱點,建立類似學術界的「同行評審」(Peer Review)機制。
然而在實際防禦操作上,OpenAI 執行長山姆·阿特曼(Sam Altman)與 Anthropic 執行長達里奧·阿莫迪(Dario Amodei)則傾向更激進的體制化方案:讓獨立第三方安全評估人員直接常駐企業內部,取得比擬內部員工的系統權限,直接從底層檢查模型演算法與安全架構,而非僅隔著 API 進行黑箱測試。
阿特曼亦公開表態支持制定全產業界通用的風險評估標準,並推動正式向公眾與政府通報安全事件的揭露機制。熟悉 OpenAI 戰略的人士進一步指出,該公司的防禦規劃正延伸至模型生命週期的更早階段——從「訓練前」的演算法資料審查,到「發布前」的多方驗證,結合民間跨企業協作與政府監管力量,試圖在下一代更具自主能力的模型帶來不可逆衝擊前,構築出一套跨越企業藩籬的聯防體系。
- 延伸閱讀:Anthropic 推出新一代 AI 模型 Claude Opus 5.5:效能大躍進、成本大砍 40%
- 延伸閱讀:Anthropic執行長前腳喊話「AI 必須踩煞車」背後卻打算釋出 Fable 5.2 與 Opus 5.5,還打算讓算力成本砍半
- 延伸閱讀:前Anthropic研究員離職工程師警告AI失控,開源大老反嗆:像冷氣維修工談氣候變遷


請注意!留言要自負法律責任,相關案例層出不窮,請慎重發文!