

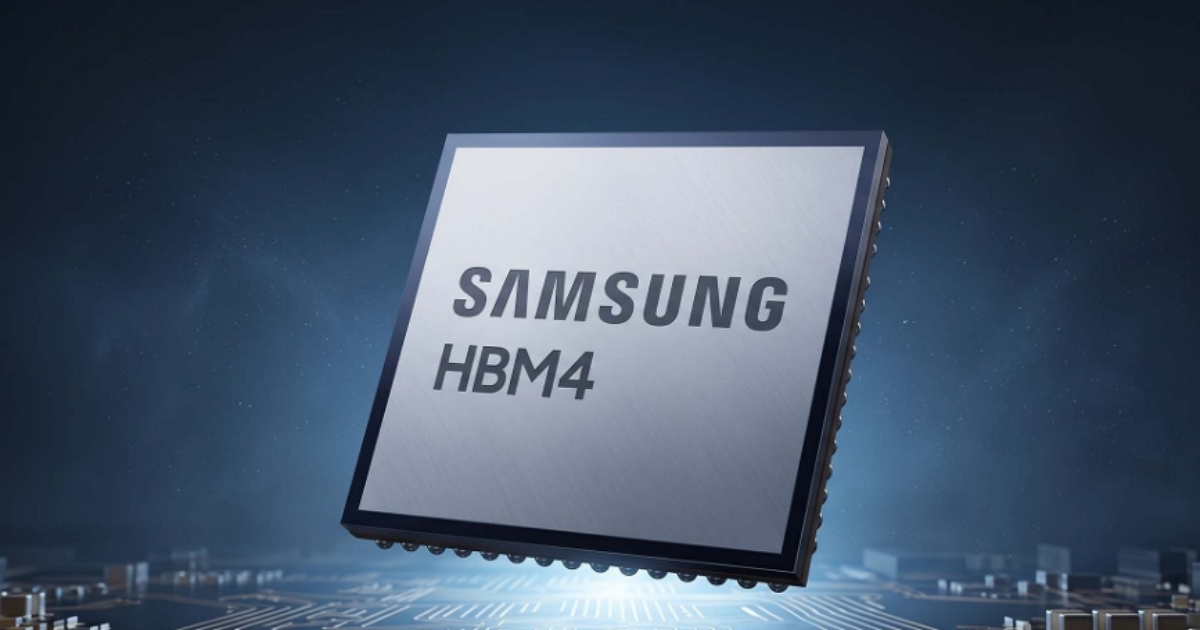
AI 算力競逐從晶片運算核心轉向記憶體頻寬,但隨著先進封裝與材料複雜度激增,高頻寬記憶體已成為伺服器中最沉重的成本負擔。
南韓半導體大廠三星電子(Samsung)正加速推進新一代 HBM4 量產時程。業界傳出其報價可能飆升至現行 HBM3E 的三倍,關鍵在於底層首次整合先進製程邏輯晶片,並採用更高層數的垂直堆疊與極限封裝。三星企圖藉此架構技術突圍,在下一輪 AI 伺服器升級浪潮中爭取更多訂單以縮小競爭差距。
導入先進製程邏輯基底晶片,堆疊工藝推升製造成本
市場預期 HBM4 將成為記憶體歷史上量產成本最高昂的產品之一。與前代 HBM3E 相比,新架構除了大幅拉高傳輸頻寬與運算效率外,最大的結構變革在於底層基礎晶片(Base Die)改由先進製程節點打造。這項製造工藝的升級,直接推升了晶圓代工與材料端的初期投入成本。
隨著堆疊層數向上推升,晶片在微縮封裝過程中的良率控制與熱管理難度倍增,使整個生產鏈的成本結構發生劇烈變動。
近年來 SK 海力士(SK Hynix)在 HBM 領域取得顯著優勢,三星則將 HBM4 視為扭轉局勢的戰略關鍵。面對製程難度大增的現實,三星正全力確保下一代生產線的穩定性,期望能在高昂定價與極限工藝之間取得平衡,藉此爭取國際雲端運算巨頭的青睞。
晶圓產能全面傾斜高頻寬,記憶體面臨供應排擠
HBM4 的價格飆升並非單純源自工藝複雜度,背後更有終端加速器持續強勁的採購力道支撐,供不應求的現況讓上游享有極高的議價彈性。
輝達(NVIDIA)、超微(AMD)與大型雲端服務商維持龐大採購規模,促使三星、SK 海力士與美光(Micron)大舉將晶圓產能轉移至高頻寬產品。這項資源調度直接擠壓到傳統 DRAM 的供應產能,導致個人電腦、智慧型手機與一般消費性電子產品的記憶體供給空間受到限縮。
即便未來整體 AI 資本支出增速有所趨緩,記憶體廠商短期內也難以迅速將先進產能調回常規規格,這項結構性失衡預計將持續數年。
- 延伸閱讀:三星 4nm 與 2nm 擴產預備!不僅為了 HBM4 更要通吃特斯拉與 Exynos 訂單
- 延伸閱讀:NVIDIA下一代Rubin GPU傳規格大變!為了確保出貨改推「8層HBM4」避開產能瓶頸
- 延伸閱讀:輝達重啟 Rubin CPX 專用 AI 加速器:捨棄 GDDR7 改搭 168GB HBM4,專攻超長上下文預填充架構


請注意!留言要自負法律責任,相關案例層出不窮,請慎重發文!