

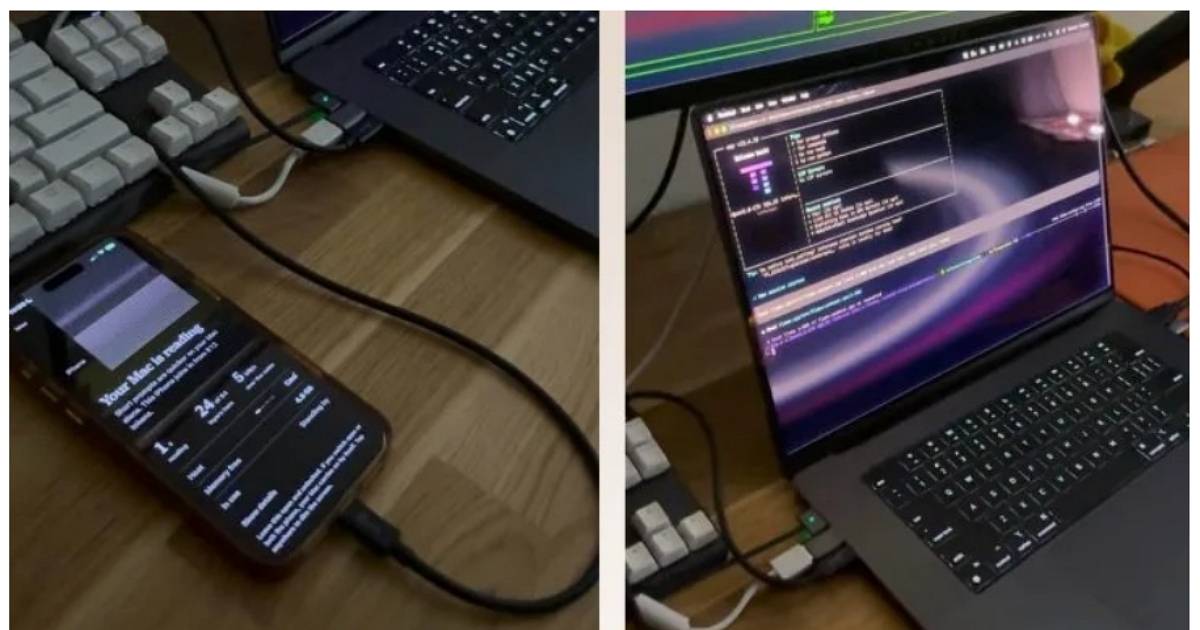
本機端部署開源大語言模型蔚為風潮,但蘋果裝置高昂的記憶體升級成本,往往讓入門款筆電在處理龐大參數時頻頻撞牆。
為突破 M4 Pro 晶片僅配備 24GB 統一記憶體的硬體瓶頸,國外開發者打造出開源專案「backburner」。他僅透過一條 USB-C 傳輸線外接 iPhone 17 Pro Max 協同分流,在執行 Qwen3.8-27B 模型時,成功讓提示詞預填充速度最高飆升 44%。
跨裝置分層流水線架構,A19 Pro 讓預填提速 44%
根據國外科技媒體《Wccftech》報導,Reddit 社群開發者 u/StayLameBro 嘗試在搭載 M4 Pro 晶片的 MacBook Pro 上運行 Qwen3.8-27B,卻受限於 24GB 記憶體容量。
為解決運算停滯問題,該名開發者設計了一套跨裝置流水線平行架構。每批 256 個 token 當中,MacBook Pro 負責前段第 1 至 40 層運算,並即時將激活值透過傳輸線串流至手機端;iPhone 17 Pro Max 則以 A19 Pro 晶片的 GPU 接手運算第 41 至 64 層。
當 iPhone 接手後續網路層運算時,Mac 已經無縫轉向處理下一批資料。在此架構下,手機端純靠 GPU 協同的吞吐量,比不啟用 GPU 運算整整提升了 2.4 倍。
在實際效能測試中,該方案針對長上下文的預填充加速格外顯著。以預填充 2000 個 token 文件並儲存對話的任務為例,在 8K 上下文長度下,外接 iPhone 後處理速度從每秒 132 個 token 提高至 177 個 token,效能提升 35%;而在 16K 上下文時,速度更從每秒 109 個 token 暴增至 157 個 token,漲幅達 44%。
文字生成仍依賴筆電
除了 GPU 運算外,該架構也啟用了 iPhone 的神經網路引擎(Neural Engine)。系統每累積 16K 長度的舊上下文,便會編譯為神經網路引擎模型。在 140K 極限長度下,單一 token 的寫入時間從純 GPU 運算的 279 毫秒大幅縮短至 176 毫秒;32K 窗口時預填充速度亦提升 29%。
不過這項技術目前仍有顯著物理局限。開發者指出,在 64K 上下文區間內,手機僅能加速提示詞預填充階段,隨後的文字生成工作依然完全由 Mac 本機負責。
這款名為「backburner」的專案現已在 GitHub 開源。外界預期,未來傳聞配備雙 16 核心神經網路引擎的 A20 Pro 晶片,其 NPU 吞吐量或將超越內建 7 核心 GPU,為邊緣協同運算帶來更大頻寬潛力。這類跨裝置分散式運算實驗,或將成為個人算力突破記憶體硬體封鎖的新路徑。
- 延伸閱讀:蘋果 MacBook Neo 2 傳搭載 A19 Pro、12GB 記憶體,提升 Apple Intelligence 體驗
- 延伸閱讀:iPhone 17 Pro 開箱:4800 萬長焦鏡頭與 A19 Pro 晶片有多強?
- 延伸閱讀:A19 Pro 與 A19 差在哪?快取、GPU、記憶體頻率與頻寬通通不同


請注意!留言要自負法律責任,相關案例層出不窮,請慎重發文!