

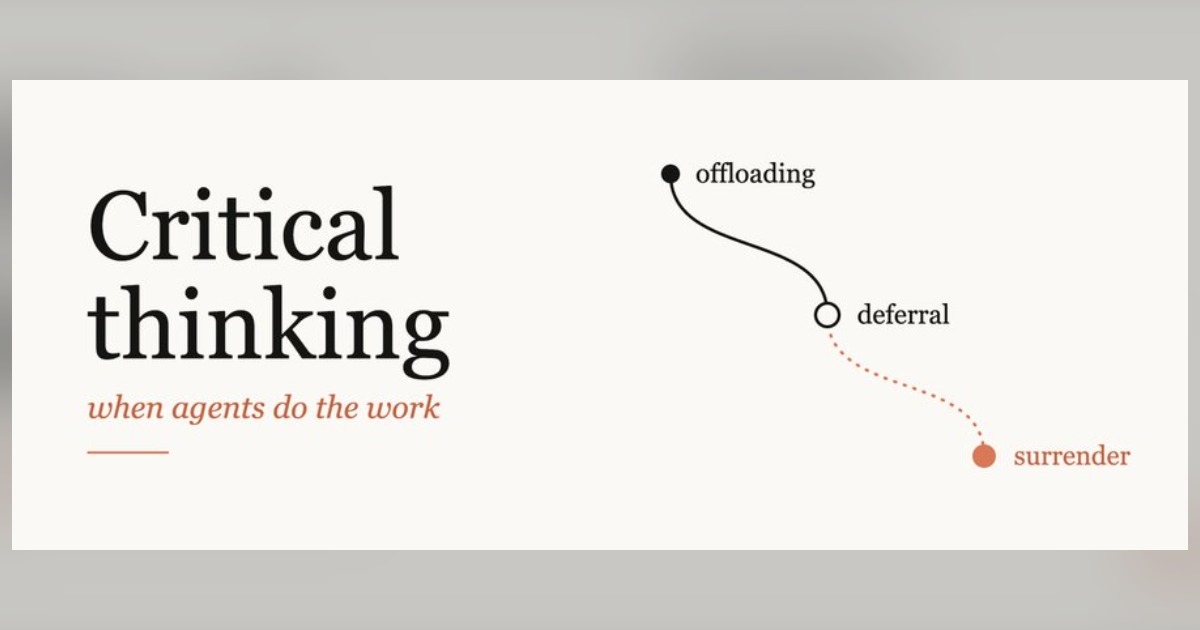
Anthropic 旗下 Claude Code 團隊工程師、前 Google 技術高管奧斯馬尼(Addy Osmani)近日發表長文提出警告,直指 AI 智慧代理愈強大準確,人類愈容易在日常依賴中放棄獨立驗證,陷入將模型輸出直接視為自身判斷的「認知投降」(Cognitive Surrender)危機。
曾於 Google 掌舵 Chrome 開發者體驗逾 14 年的奧斯馬尼指出,當前 AI 技術的最大隱憂不再是模型犯錯,而是回答過於流暢且大多正確,反而讓人類迅速解除戒心;軟體工程與知識工作的核心瓶頸正由「產出效率」急劇轉向「驗證真偽的能力」。
拆解認知投降三階段歷程,程式碼累積未解架構負債
身為 AI Agent 工作流的積極實踐者,奧斯馬尼日常工作中經常同時調用多個 Agent 運作,但他敏銳察覺到一個危險變化:隨著模型進步與明顯錯誤減少,使用者驗證答案的動機正急劇萎縮。
他將人類使用 AI 的狀態細分為三個漸進層次:首先是「認知卸載」(Cognitive Offloading),將繁雜任務交給 AI 但維持嚴謹檢查;其次是「推遲判斷」(Deferral),預設 AI 正確並直接作為下一步工作的依據。
最後則是「認知投降」(Cognitive Surrender),完全喪失查核意識,直接把 AI 的輸出當成自己的判斷,徹底放棄自主思考與驗證。
這項概念最早源自賓州大學華頓商學院研究員史蒂芬·蕭(Steven Shaw)與吉迪恩·納維(Gideon Nave)的學術論文《思考——快速、緩慢與人工智慧:AI 如何重塑人類推理及認知投降的興起》。
奧斯馬尼警示,這種心態在軟體工程中將迅速演變為致命的「認知債務」(Cognitive Debt)——AI 能自動撰寫大量程式碼且測試全部綠燈通過,但團隊成員對底層架構的理解卻歸零,一旦面臨重大架構調整或故障,將無人能夠修復與維護。
不過奧斯馬尼也補充,工程師不必強記所有程式碼細節,如同 Claude Code 團隊亦會藉由 AI 重新梳理模組邏輯;真正的關鍵在於清楚自身盲點,並維持重新理解架構的核心能力。
驗收需檢視日誌與決策假設,定期自主練習防能力退化
面對代碼驗證瓶頸,奧斯馬尼強調軟體業的競爭焦點已從「撰寫程式碼」轉變為「驗證程式碼」。由於測試腳本本身也可能由 AI 產生,兩者若存在相同邏輯盲點,通過測試並不代表系統毫無漏洞。
因此,專業交付的驗收依據必須建立在實際運行日誌、真實測試結果與畫面截圖等可客觀驗證的證據上,而非模型產生的漂亮文字摘要;同時應強制 Agent 列出任務中的自主決策、核心假設與忽略條件。
此外,多個 Agent 並行產出引發的審核塞車更形成了「編排稅」,團隊正面臨棘手的「監督悖論」:監督先進模型需要深厚專業素養,但過度依賴 AI 卻會造成能力退化。
奧斯馬尼建議工程師每週應自主安排不依賴 AI 的純手寫程式碼時間,維持專業敏銳度;在容錯成本低的事務上可全力借重自動化,但在涉及產品安全與重大抉擇時,人類絕不能把最終責任隨同工作一起交出去。
- 延伸閱讀:AI 玩太兇真的會變笨?跨國研究警告 LLM 就像「認知病毒」,小心陷入思維外包的陷阱!
- 延伸閱讀:《Nature》研究顛覆你過去對愛車為何會生鏽的認知:雨滴滑過車體表面會產生電位差,效果相當於微型閃電
- 延伸閱讀:在 TikTok 上引發熱議的「翹小指運動」,真的能阻止認知功能退化嗎?


請注意!留言要自負法律責任,相關案例層出不窮,請慎重發文!