

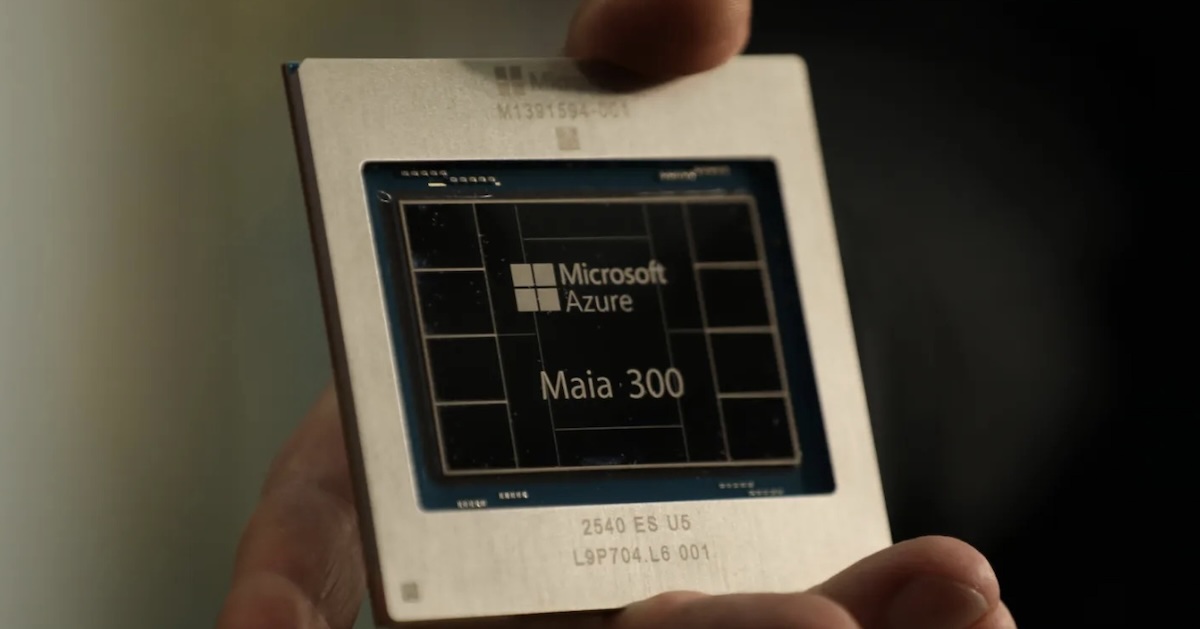
微軟正式公布第三代自研人工智慧晶片Maia 300,預計2027年起導入生產環境。官方指出,該晶片每兆瓦電力能處理的Token量較現行主流GPU高出40%,96顆晶片組成的機架級吞吐量更達到前代7倍,未來將全面支援Copilot等推論負載。
台積電N2P搭小晶片設計,專攻長上下文與代理人推論
在半導體製造端,Maia 300採用台積電N2P先進製程,並全面導入小晶片(Chiplet)架構。這項設計將運算核心、記憶體控制器與傳輸介面拆分為獨立模組,大幅提升矽晶圓的使用彈性。
微軟Azure硬體團隊指出,小晶片技術能將珍貴的晶片面積保留給關鍵運算單元。對於AI加速器而言,資料在核心與記憶體間的搬移延遲往往是最大效能殺手,模組化劃分能確保資料傳輸不致拖累運算單元,達成功耗與成本的最佳平衡。
相較於過去單純追求峰值算力的硬體,Maia 300鎖定真實業務場景的長上下文對話與多步驟AI代理任務。這類應用牽涉頻繁的工具調用與即時反應,需要更大的記憶體吞吐量與極低延遲,因此微軟選擇從底層微架構重構硬體邏輯。

96顆加速器組成機架,每兆瓦算力效率提升40%
衡量AI推論成本的關鍵在於Token生成效率。微軟估算,Maia 300每兆瓦(MW)電力能處理的Token總量較當前領先GPU增加40%,意味著資料中心能在受限的電網配額內,承載顯著增加的用戶併發請求。
AI資料中心不僅面臨昂貴的加速卡採購支出,供電配電、水冷散熱與變電所容量更已成為物理限制,能源使用效率的提升直接決定了企業營運成本。
除了單晶片能效,微軟在系統層級亦下足功夫。在單一機架部署96顆Maia 300的完整配置下,機架級Token吞吐量最高達到前代Maia 200的7倍,顯示晶片間的高速互連技術與叢集排程已成為整體系統設計的核心考量。
官方同時強調,機架吞吐量提升是針對特定分散式推論架構的綜效表現,並非代表所有單一運算任務都能獲得等比例增長,實際負載表現仍須仰賴軟體層的最佳化調度。
軟硬協同深化自研生態,多供應商策略抗衡晶片壟斷
自研硬體的價值不僅止於硬體規格。微軟AI負責人穆斯塔法·蘇萊曼(Mustafa Suleyman)強調,當AI服務規模達到臨界點,硬體與自研模型必須協同設計,讓自家模型在專屬晶片上發揮最高效率,以對抗產業競爭。
目前包括Google發展的TPU以及亞馬遜推出的Trainium晶片,皆已在雲端服務中驗證自研加速器的戰略價值。微軟加碼Maia系列,意在強化自身在AI軟硬體全堆疊的主控權,降低受制於特定供應商的風險。
微軟雲端業務執行副總裁史考特·格思里(Scott Guthrie)說明,公司規劃自2027年起將Maia系列部署規模擴大至吉瓦等級,但這並不代表全面放棄外部採購,微軟仍會依任務需求混用輝達與超微的GPU。
- 延伸閱讀:不只靠輝達!Anthropic傳聯手三星博通開發最強AI晶片,2奈米黑科技規格曝光
- 延伸閱讀:AI晶片需求太瘋狂!傳台積電將釋出部分CoWoS核心封裝訂單,日月光等封測大廠正準備搶AI大單!
- 延伸閱讀:美國製造輝達AI晶片真的快來了!台積電亞利桑那廠4奈米試產成功,連鴻海、緯創都已在德州卡位接應


請注意!留言要自負法律責任,相關案例層出不窮,請慎重發文!