

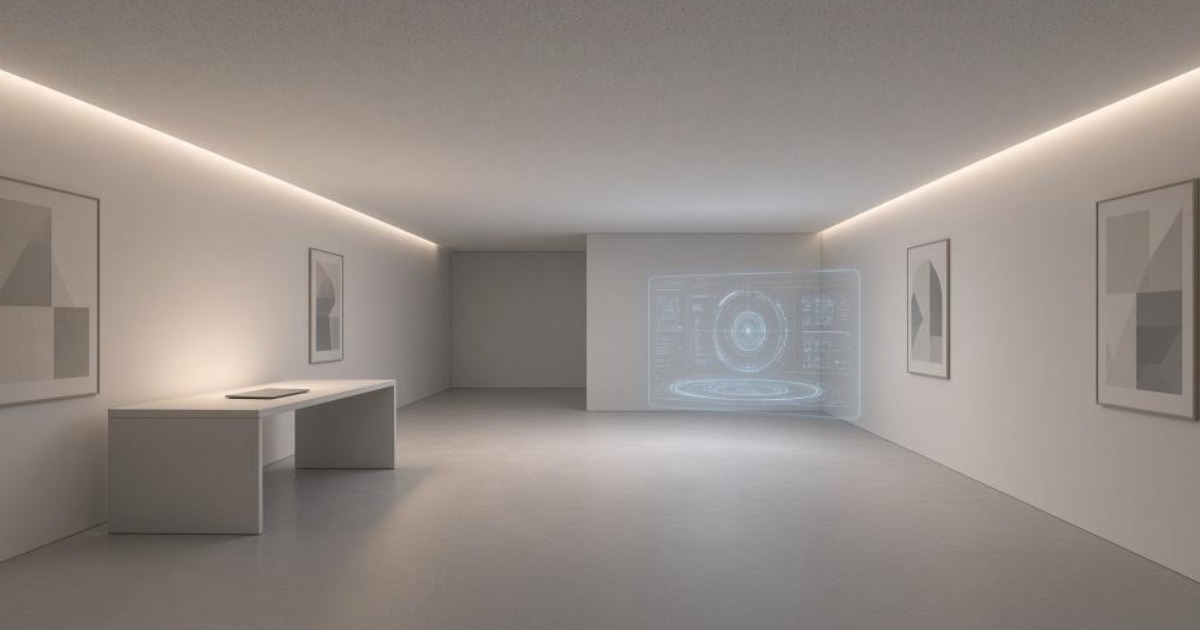
社群平台近日掀起一波名為「空房間」的生成式 AI 心理測驗狂潮,吸引全球數百萬名網友跟風實測。使用者只需上傳一張空無一物的毛坯房照片,並對 ChatGPT 下達「用你所知道關於我的一切資訊,填滿這個房間」的簡短指令,系統便會在十幾秒內生成一張細節驚人的全景臥室圖,將用戶過往所有聊天隨口提及的隱私細節徹底實體化,甚至連一年前隨手拍下詢問過的小蟲都被做成標本擺上書桌。

這場原本看似有趣的社群狂歡,隨即引發科技圈對演算法窺探隱私的集體焦慮。
多位資深分析師與跨國研究團隊深入剖析指出,這幅看似貼心的個人化房間圖,本質上是一幅由大語言模型未經許可拼湊出的「演算法自畫像」;最新學術論文更踢爆,ChatGPT 內部高達 96% 的個人記憶都是系統背著使用者自行建檔儲存,甚至悄悄建立了包含健康、願望與潛在傾向的長期心理側寫。
一句提示詞召喚隱私全景室,分析師橫評各大模型揭露窺探程度
掀起這波熱潮的波蘭網友雅各·辛楚克(Jakub Szymczuk)分享,他隨手拍了一張家徒四壁、滿是水泥灰色牆面的空房間照片餵給 ChatGPT,僅輸入一行簡單提示。沒想到短短十幾秒後,生成出來的高畫質影像令他頭皮發麻,房間內堆滿了他平時在對話中無意間透露的生活痕跡,從工作習慣、日常愛好到私密嗜好無一遺漏,整間屋子宛如一座個人專屬的 24 小時全景監控室。
最令人毛骨悚然的細節出現在電腦桌角落,畫面上居然繪製了一個玻璃罐,裡面清晰裝著一隻名為「衣魚」的室內常見昆蟲。Szymczuk 回想了許久才猛然驚醒,自己早在一年前曾拍下家中爬行的不知名蟲子,隨口上傳詢問過 ChatGPT 這到底是什麼生物;沒想到這段連他自己都早已遺忘在腦後的零碎對話,早已被演算法一五一十地刻印在後台資料庫中。
平時與 AI 聊天時知道系統會累積資料是一回事,但當這些隱私碎片真正化為一張高畫質大圖攤在眼前時,依然讓人不寒而慄。
隨著 Jakub Szymczuk 的實測在社群平台上迅速擴散,全球各國網友也紛紛跟進測試自己的專屬房間,不少人曬出成果後直呼「準到不可思議」。有人在提示詞後方額外附註「but make it exaggerated(給我誇張一點)」,結果生成出來的畫面直接膨脹成一座浮誇的大型人設展覽館。
亦有生活單純的網友拿到了一片煙霧繚繞的荒蕪沼澤,周圍僅有兩隻神情冷漠的貓咪陪伴,精準折射出其孤僻的生活型態。
知名科技產業分析師派屈克·莫漢德(Patrick Moorhead)隨後使用相同的提示詞,針對當前主流大語言模型進行了一輪橫向對比評測。測試結果顯示,在抓取使用者上下文與建構個人化特徵方面,ChatGPT 的展現最為淋漓盡致且細節豐富,而 Anthropic 旗下的 Claude 則顯得相對保守甚至難以呼應過往歷史,兩者在記憶呼叫能力上有著顯著差距。
社群上一句評論道破了箇中矛盾:AI 絕對是你現階段在網路上能找到最便宜的室內裝修設計師,但與此同時,它也是這個世界上最熱衷於偷窺你一舉一動的窺探狂。
研究踢爆96%記憶為系統私下建立
許多使用者不禁疑惑,ChatGPT 究竟憑什麼能對使用者的真實生活瞭若指掌。
事實上,OpenAI 的系統記憶機制主要由兩大核心支柱構成:第一是明確記錄使用者姓名、偏好、目標等靜態資訊的「已儲存記憶(Saved Memories)」;第二則是能跨越數百輪歷史對話、自動檢索過去有用背景資訊的「參考聊天歷史(Reference Chat History)」。房間裡擺設的每件物品,本質上都是用戶在歷次對話中隨口洩漏的資訊,正是這兩項特性的結合,讓零散的發言逐步拼湊出完整的立體人格。
為了釐清 AI 究竟在使用者背後偷偷記錄了哪些資料,來自德國馬克斯·普朗克研究所(Max Planck Institute)與波鴻魯爾大學等機構的研究團隊,在學術會議 ACM Web Conference 2026 發表了一項突破性論文。
研究人員依據歐盟《通用資料保護規則》(GDPR)賦予的合法權益,招募了 80 位真實的 ChatGPT 用戶導出個人歷史數據,並無償捐出其全部聊天紀錄作為實證分析樣本,藉此檢視演算法後台的真實面貌。
研究團隊巧妙利用了 ChatGPT 內部專門寫入記憶的小工具。每當系統決定將一項特徵寫入記憶庫時,後台紀錄檔中都會留下名為「Model set context updated(模型上下文已更新)」的系統標籤。研究人員循著這條時間戳記逆向回溯,精準比對究竟是使用者的哪一句特定發言觸發了 AI 的紀錄動作,最終從 65 名受試者、共 1,058 段對話與兩萬多輪互動中,精確抽取出 2,050 條演算法記憶,並將這份隱性資料統稱為「演算法自畫像」。
然而,論文揭曉的三組量化數據卻令人不寒而慄。首先,高達 96% 的記憶完全是 ChatGPT 背著使用者私下建檔儲存的。研究人員在觸發更新的前置語句中全面檢索「記住」或「忘記」等明確指令,結果在 2,050 條記憶中,符合用戶主動指示的僅有區區 84 條;換言之,AI 每在後台寫入 24 條關於你的生活隱私,僅有 1 條是真正經過使用者點頭同意的。
其次,研究發現超過 52% 的記憶本質上是在對使用者進行「心理側寫(Psychological Profiling)」。研究者導入認知心理學中的「心智理論(Theory of Mind)」框架,將儲存內容劃分為願望、意圖、情緒與信念四大維度。統計顯示,AI 對用戶「願望」的記錄高達 73%,意圖佔 16%,情緒與信念則分別佔 14% 與 11%;這證明演算法並非真正在意你今天的情緒好壞,而是極度渴望摸清你長期的欲望與決策模式,比起一時的喜怒哀樂,它更在乎看穿你究竟是個怎樣的人。
更嚴重的是,有 28% 的記憶直接踩進了歐盟 GDPR 明定保護的個人隱私範圍,具體人名出現在 41% 的記錄中;更有 7% 的記憶直接跨越紅線,詳細記錄了受試者的健康狀況、宗教信仰與政治傾向等「高危紅線」,其中健康個資佔比超過六成。整體而言,高達 91% 的使用者都被寫入了個人識別數據,54% 的人更被建檔了高度敏感隱私,這與 OpenAI 官方聲稱「絕不主動儲存敏感資料」的公開承諾形成鮮明諷刺。
論文甚至進行了一項更具前瞻性的模擬實驗:研究團隊利用 Gemma 與 GPT-OSS 等開源大型語言模型,仿製出一個相似度達六成的 ChatGPT 記憶提取器,並推演若將使用者的每一句發言全部納入記憶萃取將會如何。模擬結果顯示,敏感個資的佔比將從 28% 激增至 31% 至 35%,心理側寫的比例更會自 52% 攀升至 55% 到 59%,顯示舊版系統的「挑選式記憶」一旦放寬,個人隱私將無所遁形。
OpenAI引進做夢機制強化側寫,健康隱私即便刪除對話仍永久留存
為何近期 ChatGPT 的記憶能力會突飛猛進?關鍵在於 OpenAI 於 6 月針對記憶架構推動的重量級技術升級——代號「Dreaming(做夢)」的後台整理機制。如同人類睡眠時大腦會自動重組與固化白天所見所聞,ChatGPT 現在也會在非互動期間悄悄於後台「複盤」過往的所有對話,主動提煉資訊並動態重構對用戶的認知模型。
這種機制的強大之處在於時序推論與動態覆寫。舉例來說,若用戶曾於對話中提及「7 月打算前往新加坡旅遊」,等到該時限過後,做夢機制便會自動在後台將其記憶標籤更新為「曾在 2026 年 7 月造訪新加坡」。根據 OpenAI 內部的評測基準,這套全新架構讓 ChatGPT 記憶提煉的精準度自 2024 年的 41.5% 與 2025 年的 67.9%,一路暴衝至當前 V3 版本的 82.8%,同時還將伺服器後台的算力開銷大幅壓低至原本的五分之一。
然而,這項高效率架構背後卻潛藏著不可逆的個資外洩風險。許多使用者誤以為只要隨手在前端介面按下「刪除對話」,相關紀錄便會徹底煙消雲散;但研究團隊證實,刪除對話僅僅是抹去前端的文字流水帳,早已由 Dreaming 機制提煉並沉澱至底層記憶庫中的特徵標籤,根本不會隨之刪除。
這種隱患在醫療健康領域尤為致命。今年 9 月發表於預印本平台 arXiv 的另一項針對 1,057 名使用者、近 18 萬段對話紀錄的大型研究顯示,超過五分之一(21.31%)的對話都曾探討個人身體健康狀況;而其中超過 95% 的病況畫像,同樣是 AI 背著用戶偷偷建檔,數據與前述研究驚人一致。更危險的是,當演算法在後台進行語意合併時,極易將用戶某次偶發的「隨口抱怨頭痛」,永久固化並定性為「長期偏頭痛患者」的終身病歷標籤。
長期以來,公眾往往樂觀地認為自己正在親手調教一個越來越懂事的「第二大腦」;直到這張塞滿日常私密細節的房間圖毫無遮掩地甩在眼前,人們才驚覺在成千上萬句日常對話背後,被徹底扒光底牌的其實只有人類自己。在商業演算法的冷酷邏輯中,從來不存在人性化的感同身受,有的只是被明碼標價、隨時可被呼叫的個人上下文資料。
- 延伸閱讀:OpenAI宣布ChatGPT Classic將於2027年1月退役!聊天紀錄無縫遷移新版,Codex額度整併共享
- 延伸閱讀:OpenAI證實ChatGPT搜尋量達Google兩成!市占攀升且42%美成年人改用AI查資料
- 延伸閱讀:AI 翻譯不只看準確度!沉浸式翻譯通過 ISO 資安、隱私雙認證,整合 ChatGPT、Gemini、Claude 等模型,支援逾 100 種語言


請注意!留言要自負法律責任,相關案例層出不窮,請慎重發文!