

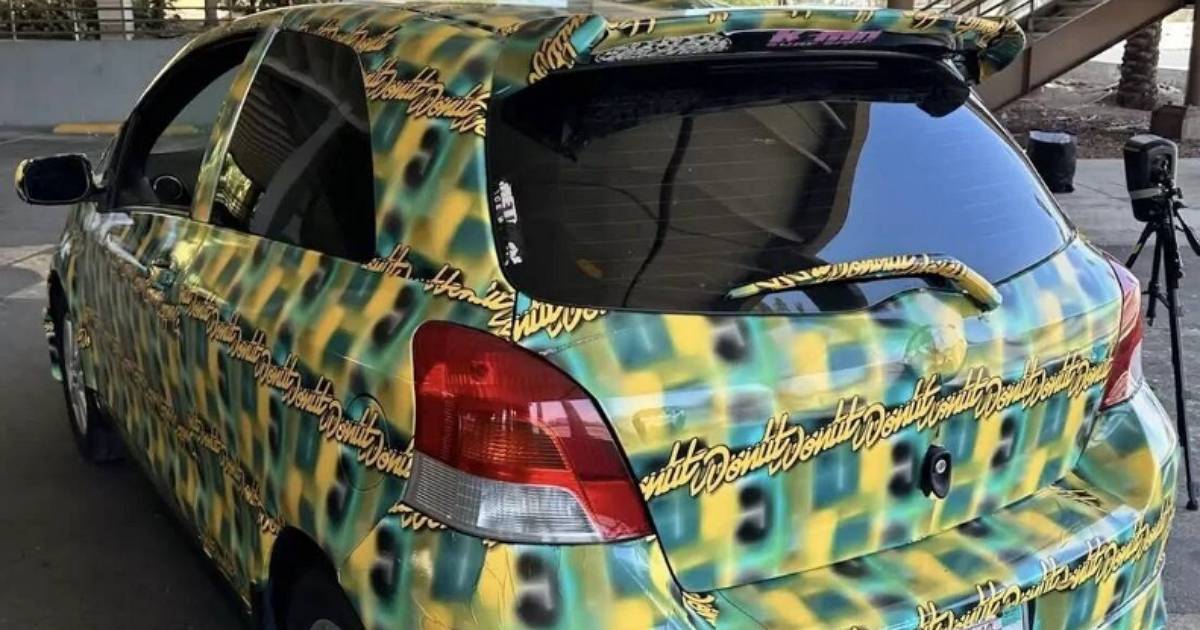
如果你開著一台百萬級的自駕車在高速公路上馳騁,前方車輛突然在車載螢幕上「憑空蒸發」,系統在毫無減速的情況下全速追撞,這不是科幻電影,而是真實世界中最新被驗證的資安漏洞。
深度學習演算法脆弱性:自駕車必須導入多感測器融合防護
在近期舉行的國際頂級資安會議上,一項針對自動駕駛 AI 視覺系統的研究震撼了整個科技界:研究人員僅憑一張特製的幾何彩色車貼,就讓市面上主流的自駕車 AI 鏡頭徹底失明。
這項攻擊的致命之處,在於研究人員完全不需要敲下一行攻擊程式碼,也不用侵入行車電腦主機。他們只需將一張經過特殊演算法計算的彩色幾何貼紙,貼在前車的行李廂蓋正中央。
當後方自駕車的攝影鏡頭捕捉到車尾畫面時,車載的主流物件偵測模型(如 YOLO 與 ResNet)會被圖案產生的噪訊干擾,神經網路瞬間誤判,直接將眼前這輛實體汽車標註為「空白背景」或「無害雜物」。在烈日、陰天、變換視角與不同跟車距離的實測下,致盲成功率高達 90% 以上。

這次實驗徹底撕開了卷積神經網路(CNN)的先天缺陷:車載 AI 只是在統計像素的色彩與邊緣機率,根本不具備理解「眼前有實體障礙物」的空間認知。
這意味著,只要有心人士在車尾貼上經過計算的幾何色塊,就能隨意製造「視覺迷魂陣」,讓造價昂貴的純視覺自駕車在路上變成毫無煞車反應的公路凶器。單靠軟體調校與增加演算法參數,已經無法修補這種來自物理世界的像素欺騙。
這項漏洞直接將壓力拋給堅守「純視覺低成本路線」的各大車廠。光學貼紙能輕易騙過攝影鏡頭,卻完全無法阻擋毫米波雷達(Radar)與光學雷達(LiDAR)發射的物理反射波。
資安專家指出,車輛必須強制導入「多感測器融合防護」,讓雷達的空間測距數據與鏡頭影像即時交叉比對;一旦鏡頭被貼紙欺騙,雷達傳回的實體障礙物訊號也能在毫秒內強制煞車,化解危機。
自駕車的安全底線,從來不在於鏡頭像素有多高、演算法算力有多強,而在於系統能否抵禦現實世界的惡意干擾。一張幾十元的貼紙,撕碎了純視覺自動駕駛的低成本神話,也清楚告訴所有車廠:在涉及人命安全的公路戰場上,省去雷達硬體的代價,終究要由乘客與行人的安全來買單。
- 延伸閱讀:裁員、關廠,Volkswagen 也要結束自動駕駛科技開發
- 延伸閱讀:《極限競速:地平線 6》自動駕駛功能引熱議,玩家吐槽「根本是三寶 AI」
- 延伸閱讀:L2、L3、NOA是啥碗糕?自動駕駛分級、輔助駕駛名詞一次講清楚!


請注意!留言要自負法律責任,相關案例層出不窮,請慎重發文!